原始 Transformer 用 Encoder 编码完整源序列,再让 Decoder 根据目标前缀逐位置预测。它与这一组文章的主线 decoder-only 的区别是多了一份源语言 memory 和读取它的 cross-attention。
先读:整体模型、Attention。接着回到 decoder-only 训练和生成。
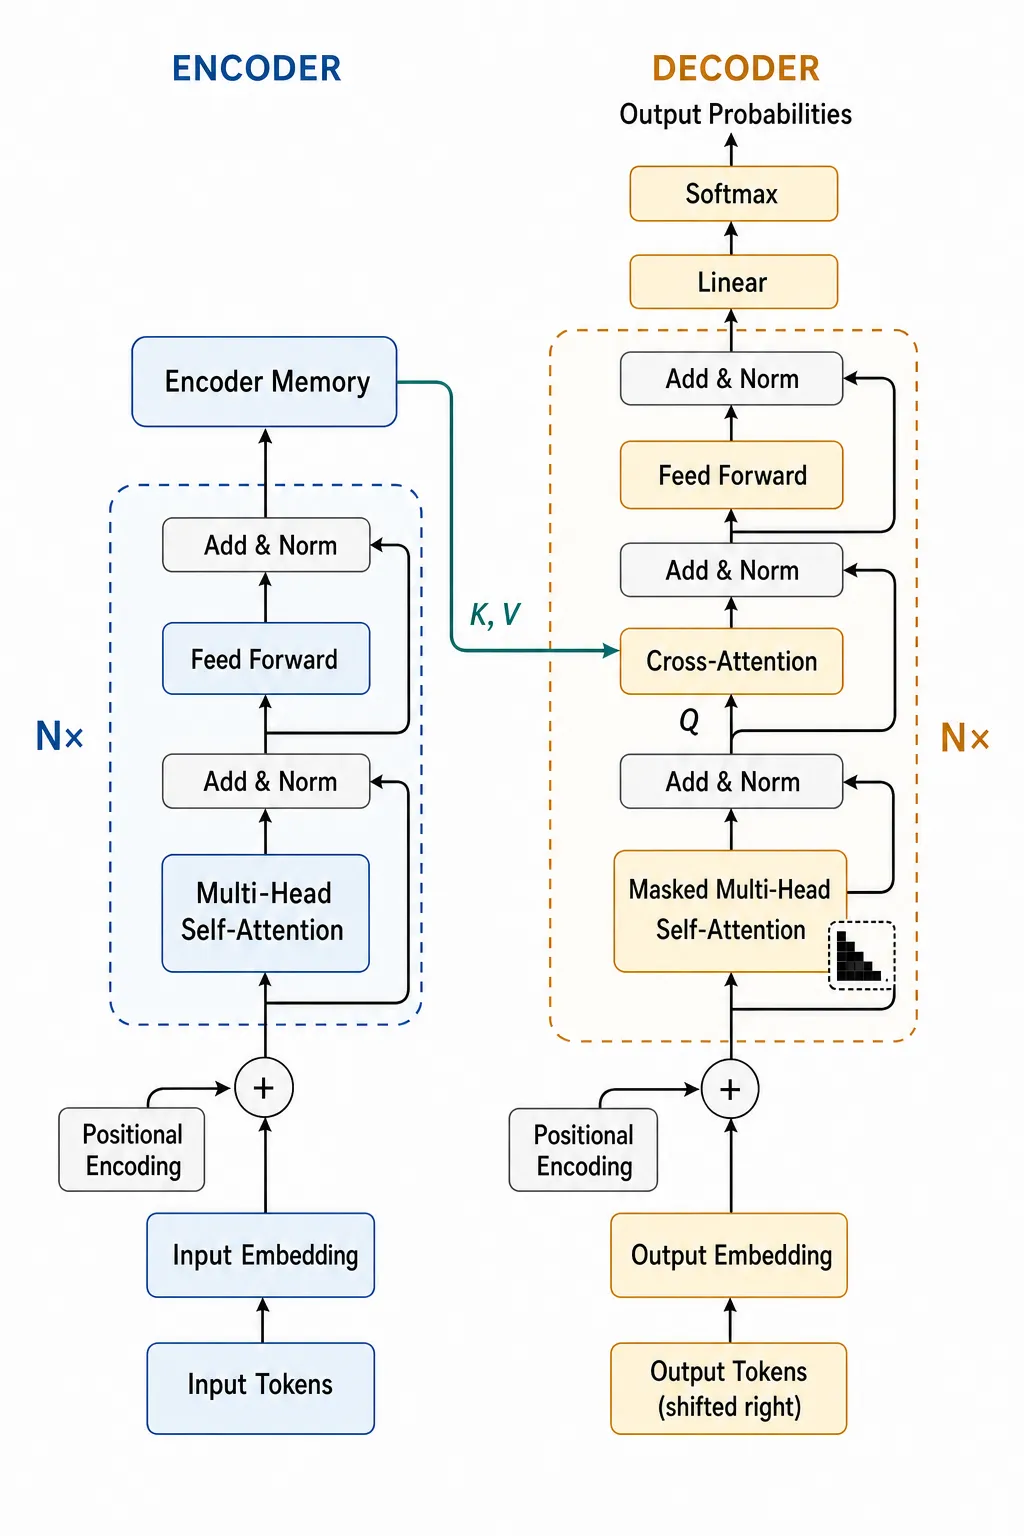
1. 整体结构
Section titled “1. 整体结构”中译英“我 有 一只 猫”→“I have a cat”:中文经过 Encoder 得到 C∈R^(4×512);英文目标前缀进入 Decoder。Decoder 的 masked self-attention 读取英文前缀,cross-attention 以当前 Decoder 表示作 Q,以 C 的每层投影作 K/V,读取中文信息。
源句已知完整,因此 cross-attention 通常不加目标侧的三角 causal mask;源句 padding 仍需遮罩。Encoder memory C 可供每层使用,但每层 cross-attention 的 K/V 投影参数不同。
论文 base 配置:D=512、Encoder/Decoder 各6层、8头、每头64维、FFN中间2048、dropout 0.1、label smoothing 0.1。原论文使用 Post-LN、正弦位置编码、Embedding 缩放与共享权重;这些不是所有现代模型都采用的固定配置。
训练与推理图:原始翻译例子
Section titled “训练与推理图:原始翻译例子”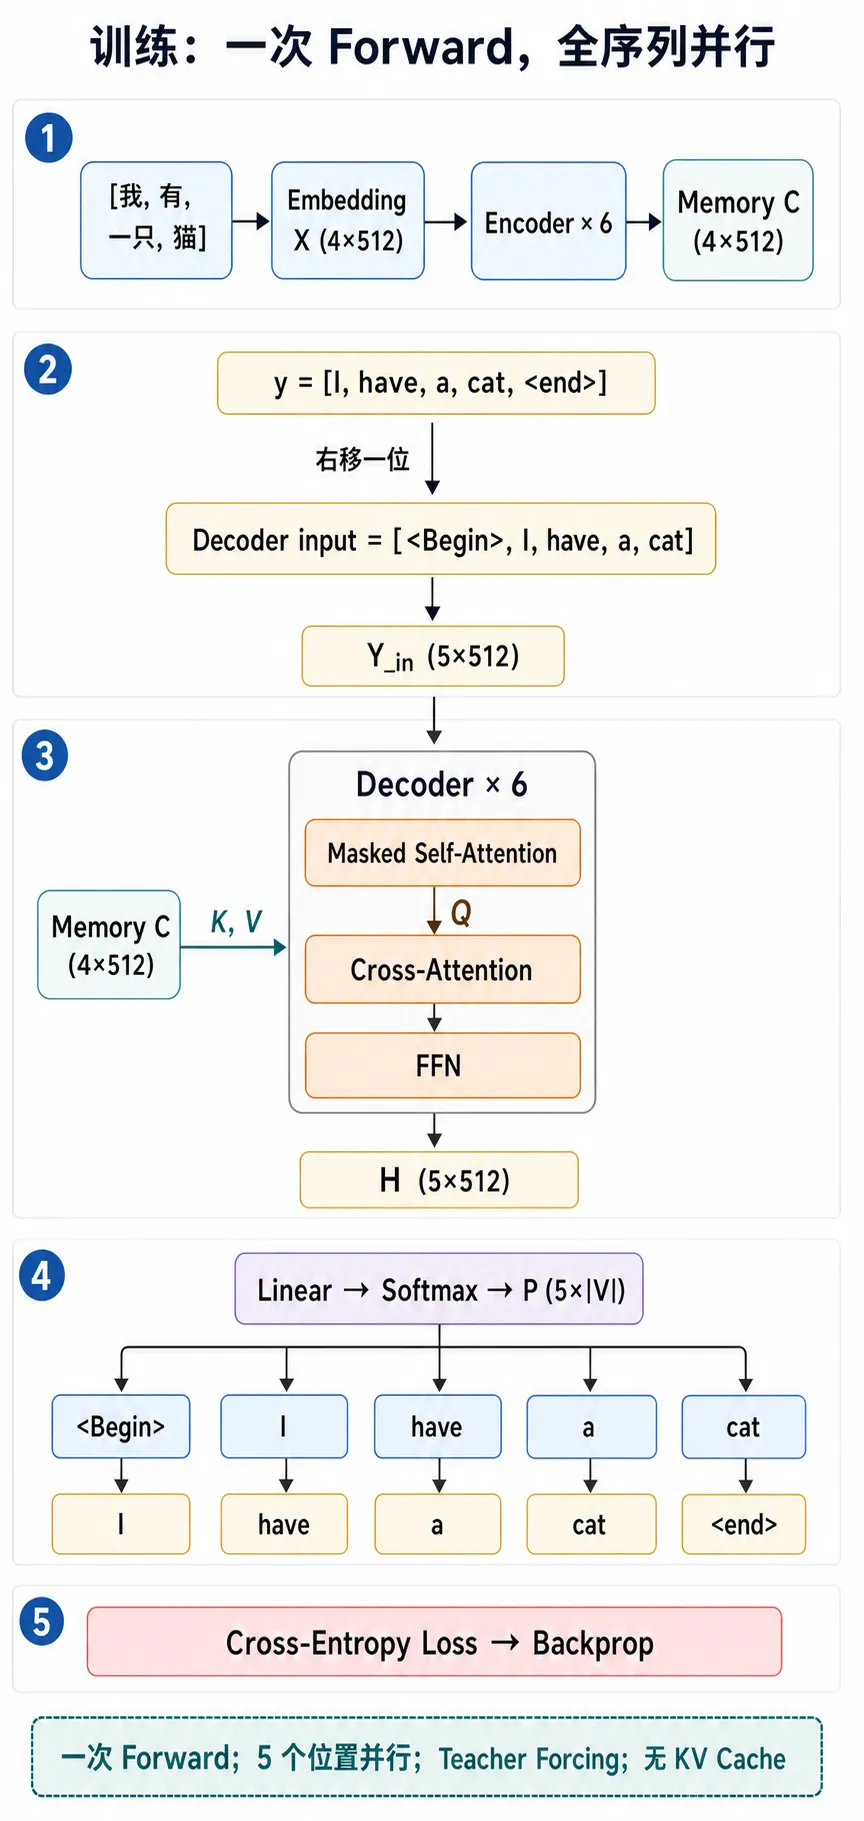
训练标签 [I,have,a,cat,<end>],Decoder 输入 [<Begin>,I,have,a,cat]。一次 forward 并行产生五个位置的分数,使用因果遮罩,按位置与标签计算 loss。Label smoothing 会把目标分布从严格 one-hot 改成平滑分布,区别于 交叉熵一文中的例子。
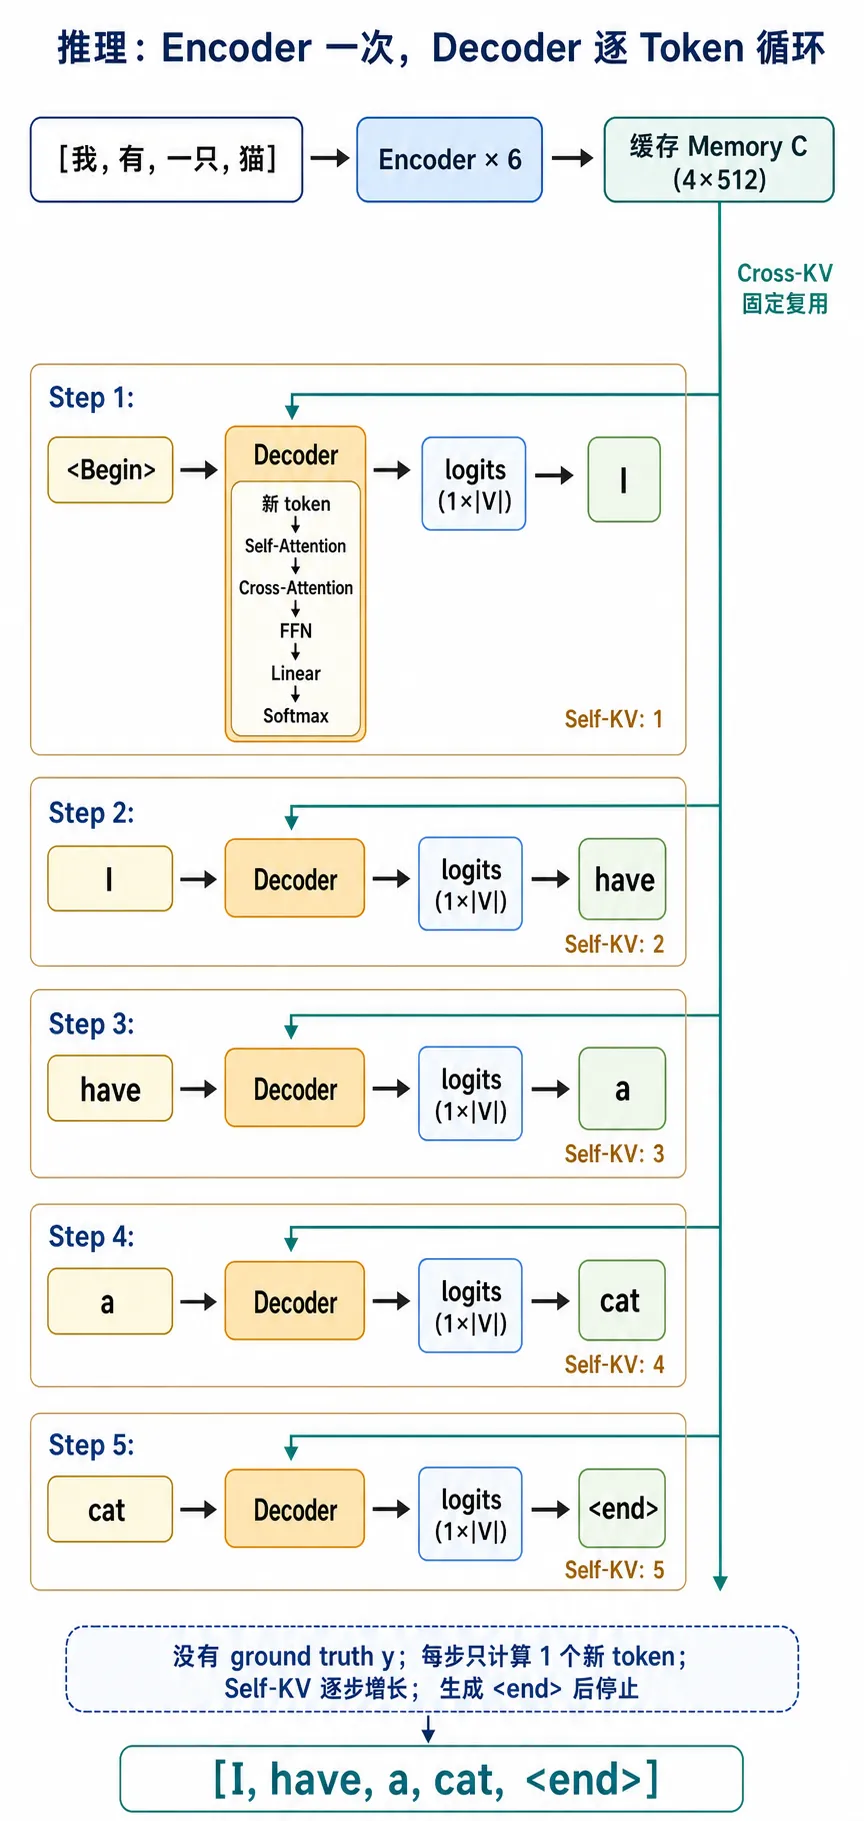
推理时 Encoder 执行一次。Decoder 先处理 <Begin>,选择 I;随后处理 I,选择 have,如此继续直到终止条件。所选 token 下一次进入 Decoder 后才产生它的 self-attention K/V。
缓存三类信息
Section titled “缓存三类信息”| 信息 | 内容 | 增长情况 |
|---|---|---|
| Encoder memory C | 编码后的源句 | 固定源句时不增长 |
| 每层 cross-attention K/V | C 的各层投影 | 固定源句/权重时可复用 |
| 每层 self-attention K/V | 已处理的目标前缀 | 随处理新目标 token 增长 |
Decoder-only 对照
Section titled “Decoder-only 对照”把“翻译成英文:我有一只猫”与“I have a cat”组织在同一序列。目标位置通过普通 causal self-attention 读取左侧 prompt,没有独立 Encoder/Cross-Attention。SFT 可只对回复位置监督;每层保存自己的 self-attention KV。
纯 Encoder 常双向读取完整输入,常规编码时没有这种目标 token 的自回归循环。BERT 等模型的训练目标和推理任务还可能不同,不能仅归结为 Dropout 开关。Whisper、T5 等说明 Encoder–Decoder 仍然有实际用途。
来源:Attention Is All You Need、Illustrated Transformer、Annotated Transformer。中文查阅:动手学深度学习。