音频交互模型调研
音频交互模型调研:交互能力、统一建模框架、代表架构、设计空间与对话动态
本页讨论音频交互模型(Audio Interaction Models)如何支持人与 AI 的自然语音交互,覆盖交互能力、统一建模框架、代表模型架构、设计空间和对话动态(conversation dynamics)。核心主线是:语音不仅传递内容,还携带时序、情绪和情境线索;模型需要持续处理用户与助手的两条音频流,并决定何时倾听、发言、停止或附和。
1 为什么需要音频交互模型
Section titled “1 为什么需要音频交互模型”这份调研从两个问题展开:
-
人为什么需要用语音和 AI 交互?
-
现有的语音助手是怎样构建的?
语音传递的不只是文字。 语音是人类实时交流的主要接口之一,同时携带韵律、时序、情绪、犹豫等文字难以完整表达的线索。
建模音频与建模交互
Section titled “建模音频与建模交互”| 维度 | 要建模的问题 | 包含的内容 |
|---|---|---|
| 建模音频 | 信号里有什么? | 语音转写;说话人信息;副语言信息与背景,包括韵律、情绪和环境声 |
| 建模交互 | 根据双方之间正在发生的事,我该做什么、在什么时候做? | 何时说话、何时保持沉默、何时附和(backchannel)、何时打断合适、用户是否已经交出话轮,以及发生重叠后如何恢复 |
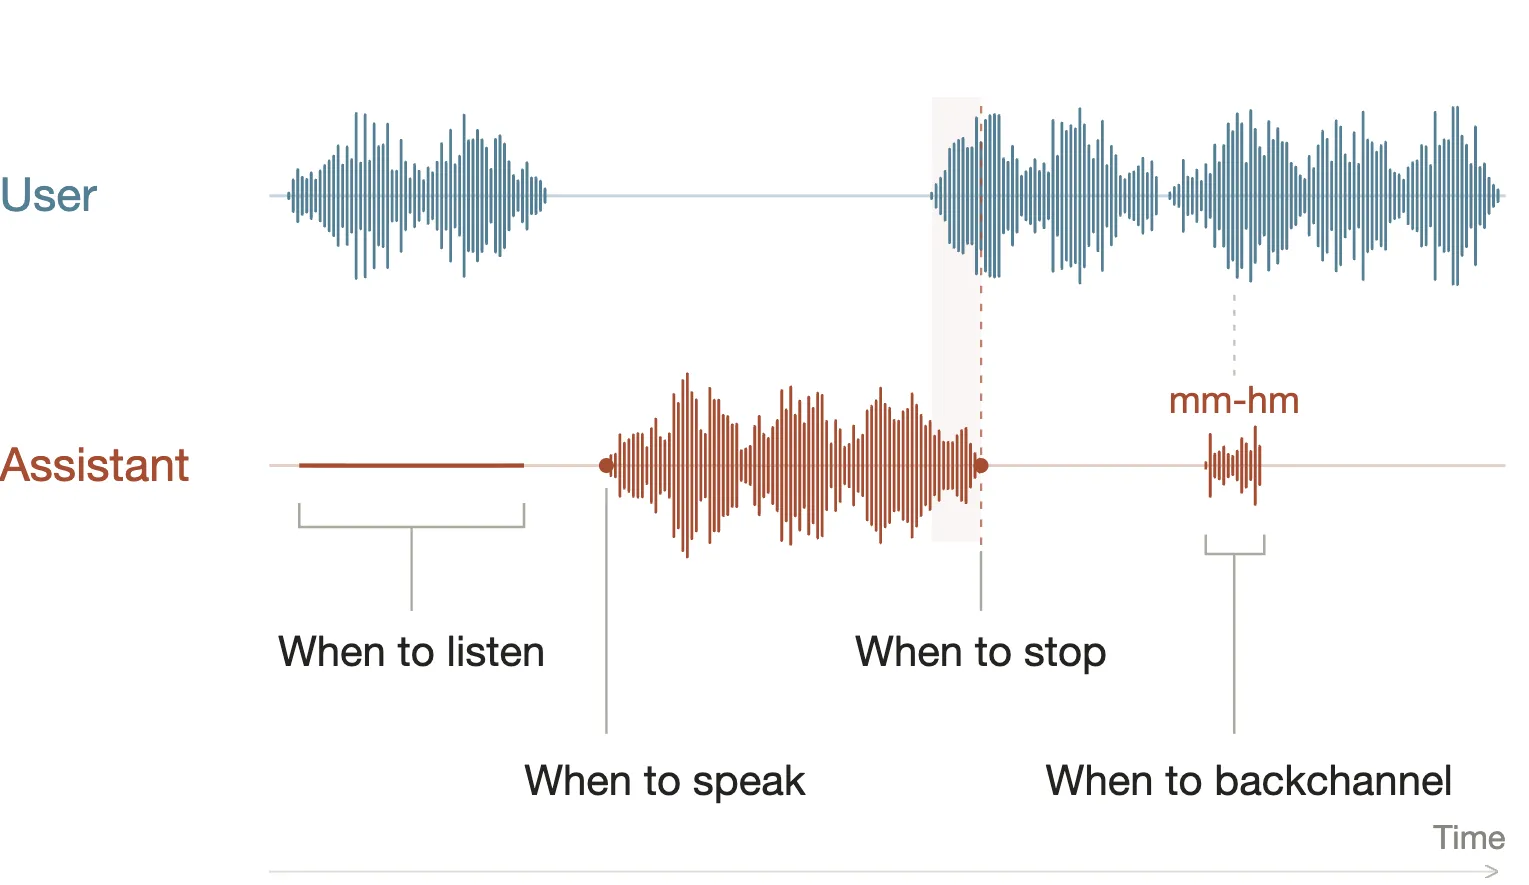
在同一时间轴上,用户说话时助手倾听;用户结束后助手开口;用户再次开口时助手可以停止;用户继续说话时,助手也可以给出简短的“嗯”作为附和。下面的波形是交互示意,不对应真实录音。
电影《Her》中的虚构对话常被用来表达对理想交互的想象。它是想象场景,不是模型性能证据。
2 代表模型展示的交互能力
Section titled “2 代表模型展示的交互能力”本节摘录三家官方发布资料中描述的能力:OpenAI GPT-Live、Thinking Machines Lab Interaction Models 和 ByteDance Seed Seeduplex。
OpenAI GPT-Live
Section titled “OpenAI GPT-Live”模型:GPT-Live。发布日期:2026-07-08。 官方发布资料。
| 能力 | 说明 | 来源小节 |
|---|---|---|
| 边听边说 | 模型说话时仍在倾听,同一段对话里输入和输出可以重叠。 | Continuous interaction |
| 自然对话 | 可以打断、停顿,或让它说慢一点。它会用“嗯”“明白”等回应,并让对话继续下去。 | More natural conversations |
| 时间感知 | 模型能直接感知流逝的时间,因此能应对停顿、快速往返和实时翻译。 | Continuous interaction |
| 背景鲁棒性 | 在你思考时等待;有车流声或旁人交谈时,注意力仍留在你的声音上。 | Better listening |
| 更强的智能 | GPT-Live 维持语音对话的进行,GPT-5.5 在后台处理搜索和更深入的推理。 | Delegation for deeper work |
| 新的 ChatGPT 语音体验 | 更自然的对话、更聪明的回答、更好的倾听、可选的推理档位、重新制作的音色和可视化卡片。 | A new ChatGPT Voice experience |
Thinking Machines Lab Interaction Models
Section titled “Thinking Machines Lab Interaction Models”模型:TML-Interaction-Small。发布日期:2026-05-11。 官方发布资料。
| 能力 | 说明 | 来源小节 |
|---|---|---|
| 无缝的对话管理 | 跟踪隐含的思考、让出话轮、自我修正,以及邀请对方回应的信号。 | Capabilities |
| 视觉插话 | 对话需要时,结合视觉上下文主动插话。 | Capabilities |
| 语言插话 | 根据上下文适时插入,不必等每个话轮结束。 | Capabilities |
| 同时说话 | 用户和模型可以同时说话,包括实时翻译。 | Capabilities |
| 时间感知 | 把流逝的时间作为交互的一部分,包括停顿和节奏。 | Capabilities |
| 同时使用工具、搜索和生成式界面 | 在听或说的同时搜索、调用工具并生成界面。 | Capabilities |
ByteDance Seed Seeduplex
Section titled “ByteDance Seed Seeduplex”模型:Seed Full-Duplex Speech LLM。发布日期:2026-04-09。 官方发布资料。
| 能力 | 说明 | 来源小节 |
|---|---|---|
| 过滤干扰,准确识别用户声音 | 滤掉广播和导航播报,识别出主要用户的声音。 | Filtering interference |
| 理解意图,忽略非交互声音 | 把真正的交互与旁人交谈等非交互声音区分开。 | Understanding intent |
| 感知环境,主动关联上下文 | 把环境声当作上下文,并与正在进行的对话联系起来。 | Perceiving the environment |
| 耐心倾听,留出思考空间 | 回应之前,为不确定的想法、停顿和自我修正留出余地。 | Patient listening |
| 超低延迟,即时回应 | 在快速往返的交流中,用户说完后迅速回应。 | Ultra-low latency |
| 敏锐感知,即时响应打断 | 识别到打断后停止说话,回到倾听状态。 | Interruptions |
3 音频交互能力的分解
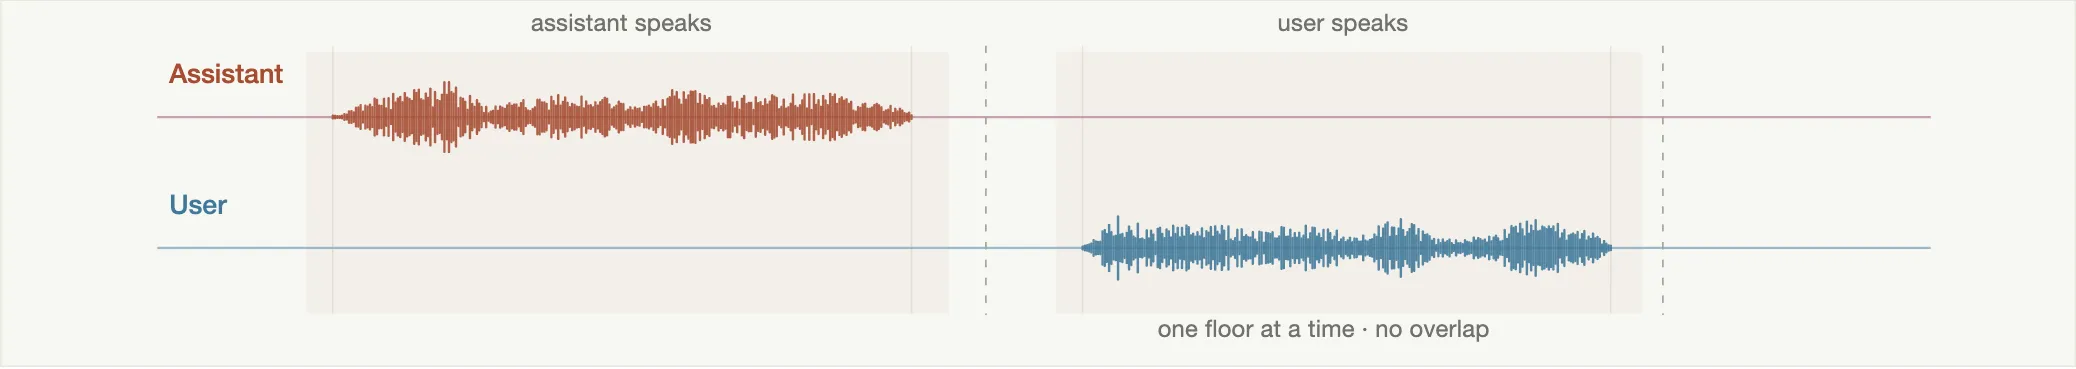
Section titled “3 音频交互能力的分解”半双工(half-duplex):一次只有一方占有话轮,助手和用户轮流说话,没有重叠。
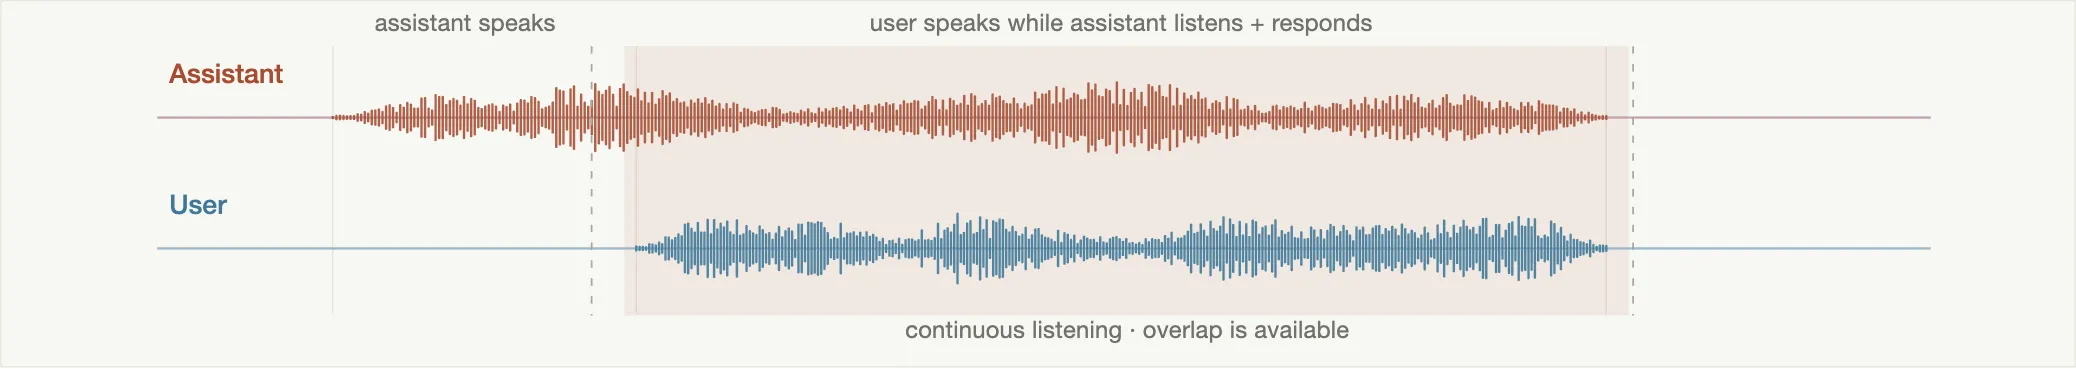
全双工(full-duplex):两条流持续在线,助手说话时仍可以倾听,用户和助手的发声可以重叠。
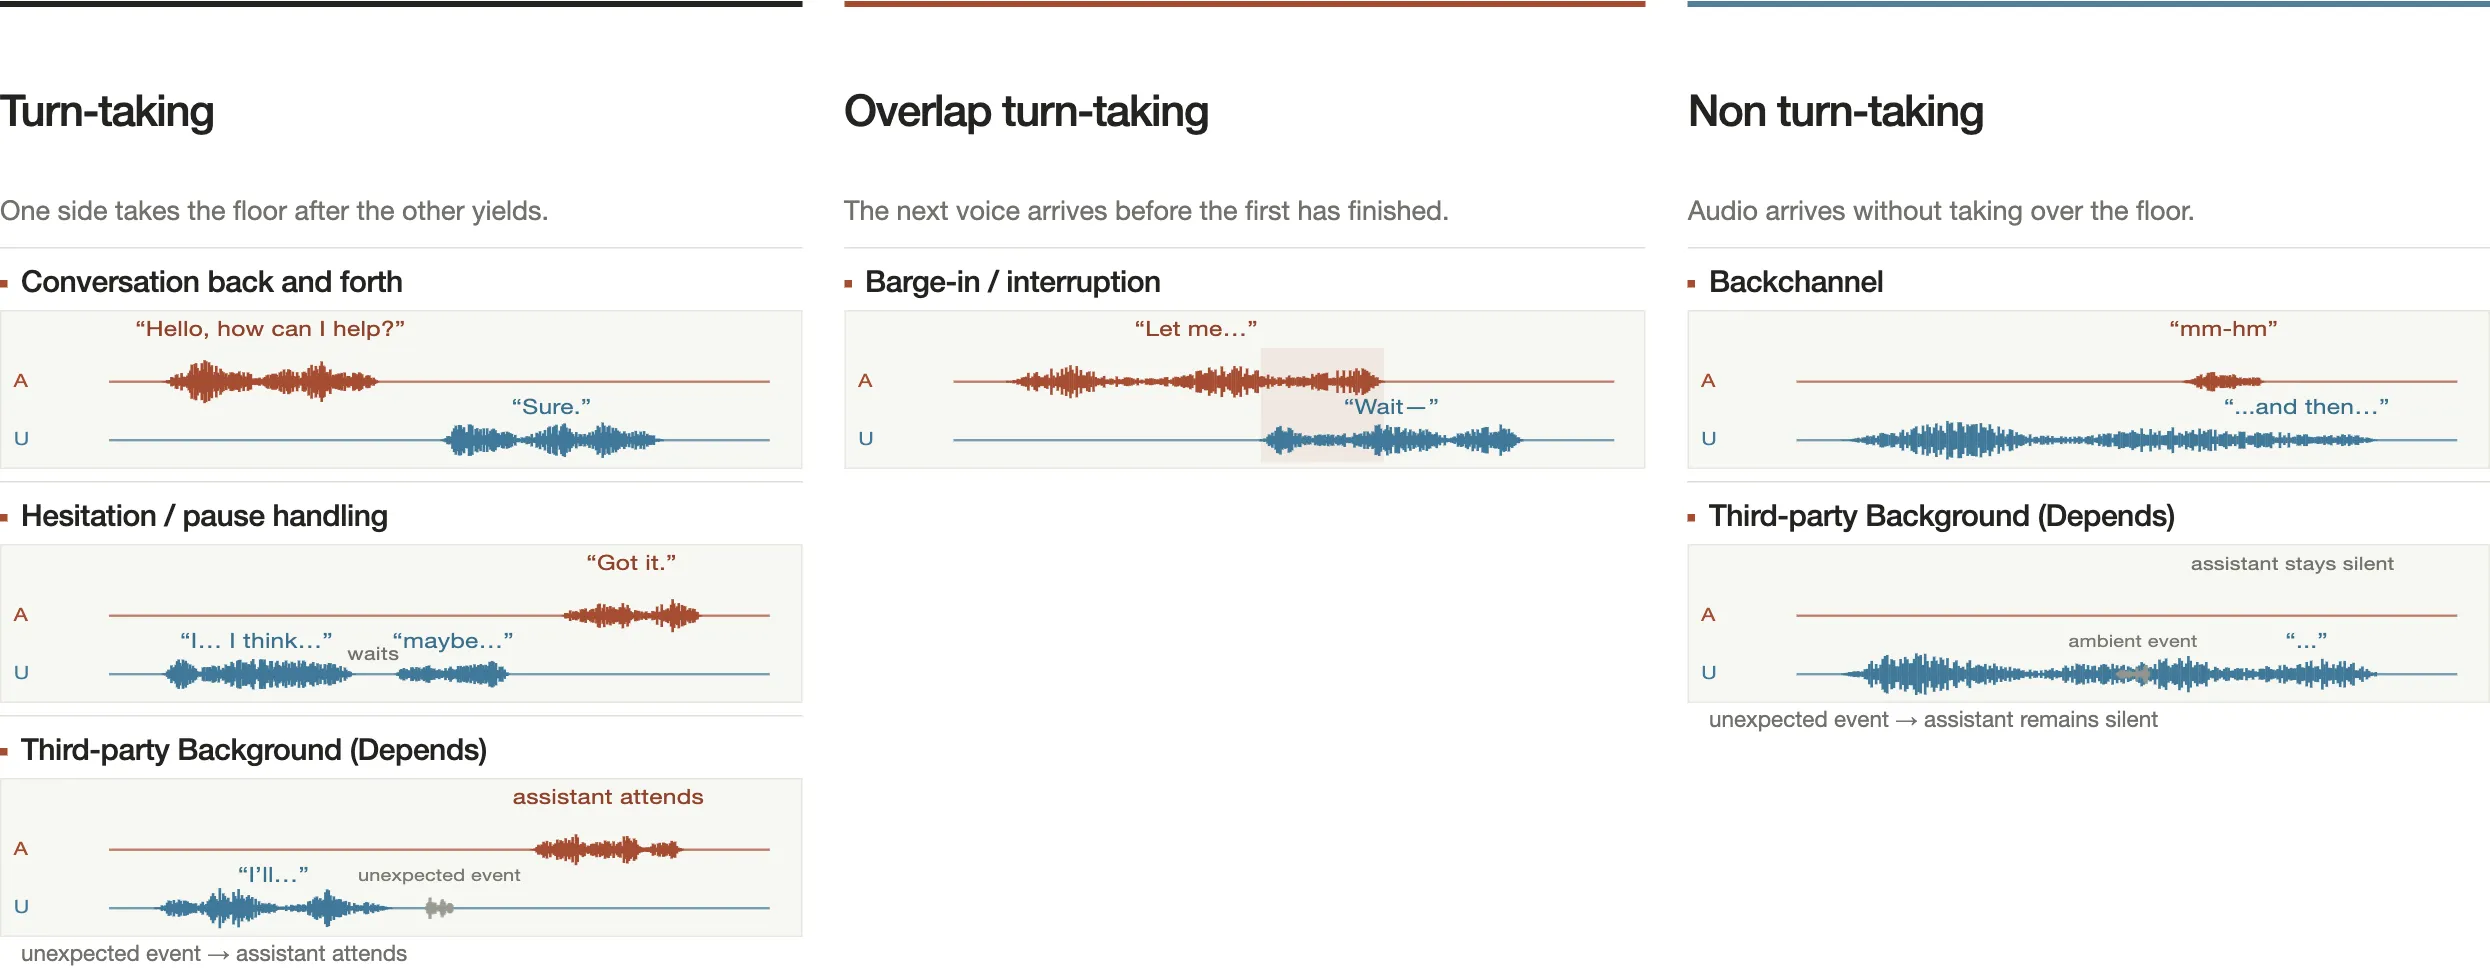
对话动态(conversation dynamics)是对人类对话时序行为的抽象。按话轮是否发生转移、转移时是否重叠,基本的动态可以分为三类。
| 类别 | 含义 | 场景 |
|---|---|---|
| 话轮转换(turn-taking) | 一方让出话轮后,另一方接过话轮 | 一来一往的对话;犹豫与停顿的处理;第三方背景声,是否转移话轮取决于情境 |
| 重叠的话轮转换(overlap turn-taking) | 前一方还没说完,后一方已经开口 | 打断(barge-in):助手尚未说完,用户说“等一下——” |
| 不转移话轮(non turn-taking) | 有声音出现,但没有接管话轮 | 附和,例如用户继续说话时助手说“嗯”;第三方背景声,助手可保持沉默 |
犹豫和停顿不必立刻触发回复。例如用户说“我……我觉得……也许……”,助手可以等待再回应。第三方背景事件也不能仅凭出现声音就归入一种类别:事件可能值得助手关注,也可能应该被忽略,是否需要接管话轮取决于情境。
交际能力(communicative competence)描述模型在交流中如何理解和表达意义。它可以拆成四种处于同一抽象层级的能力。
理解并表达正在讨论或被请求的内容。
包括:知识与推理;指令遵循;信息整合;时间推理。
最小场景:“火车 8:30 出发,路上 40 分钟。” → “你 9:10 到。”
情境语用能力
Section titled “情境语用能力”理解说话人在当前情境下的意图,并作出得体的回应。
包括:意图感知;情境感知;时间感知;参与者感知;社交得体性。
最小场景:“能再说一遍吗?” → 重复上一个回答。
共识建立与修复能力
Section titled “共识建立与修复能力”在整段对话中维持共同理解,并在出现偏差时恢复。
包括:对话记忆;上下文跟踪;澄清处理;更正处理;误解修复。
最小场景:“周二……不对,周四。” → 更新已有的计划。
声音与表达能力
Section titled “声音与表达能力”通过说话的方式理解和表达意义。
包括:情绪与态度感知;韵律感知;有表现力的发声;说话风格适配。
最小场景:同一句“我没事”,语气不同 → 回应和发声方式也不同。
4 从两条连续音频流到统一模型框架
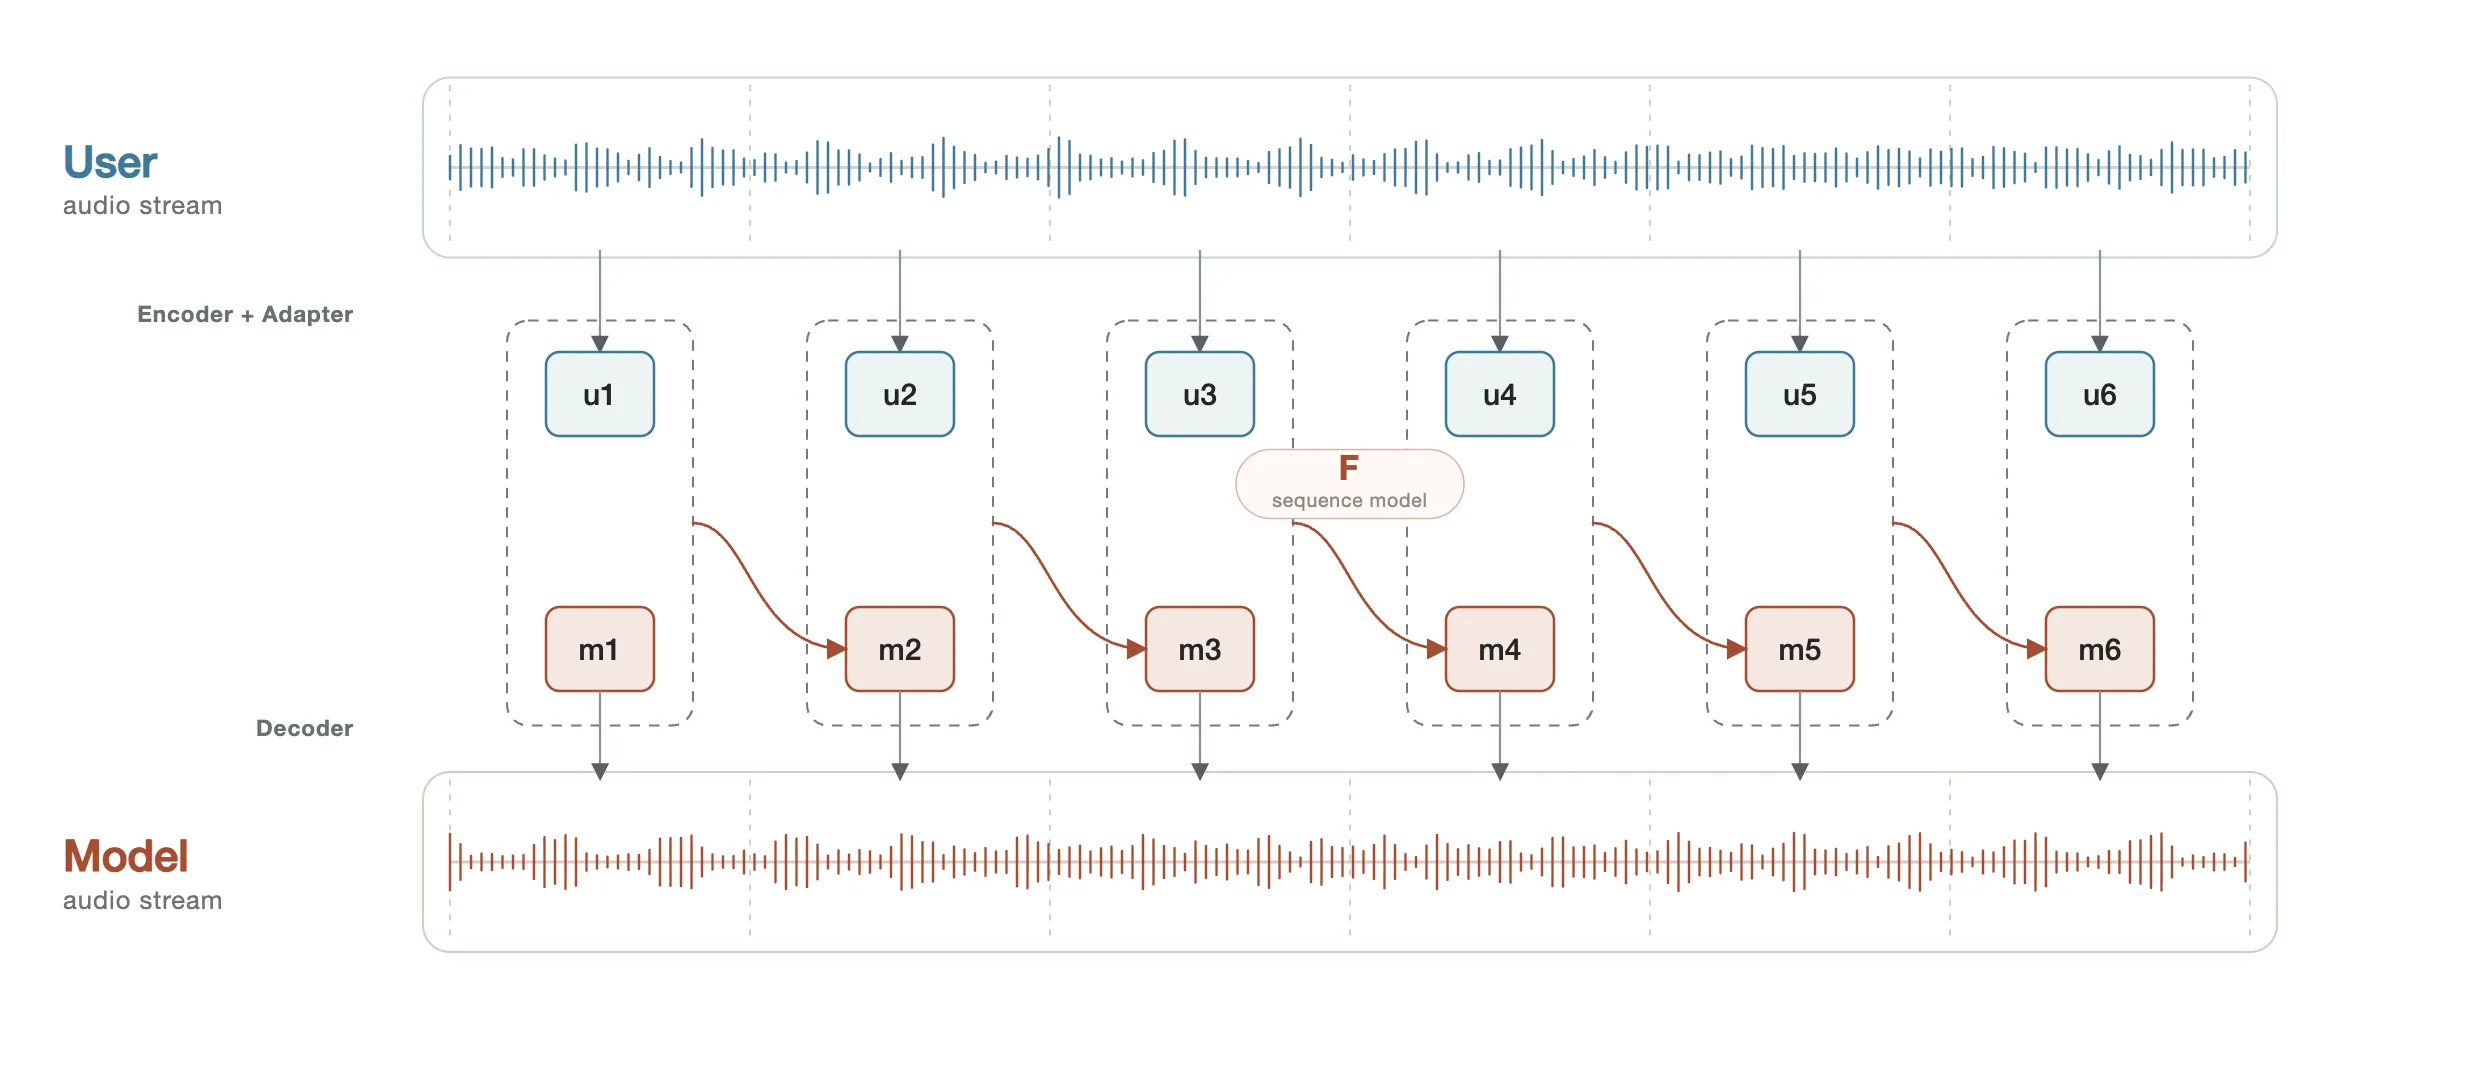
Section titled “4 从两条连续音频流到统一模型框架”交互首先可以还原成两条并发且连续的音频流:用户音频流和模型音频流在同一物理时间轴上连续存在。用窗口(window)作为通用时间单位,将对齐的用户特征和模型特征放进同一帧,再由序列模型连接前后帧。
用户音频经过 Encoder + Adapter 得到可建模的表示;Sequence Model F 处理上下文与跨时间的关系;Decoder 将模型侧的表示还原成音频。图中的窗口是通用建模单位,不代表所有模型都采用相同的帧长或内部结构。
E A F D 的统一视角
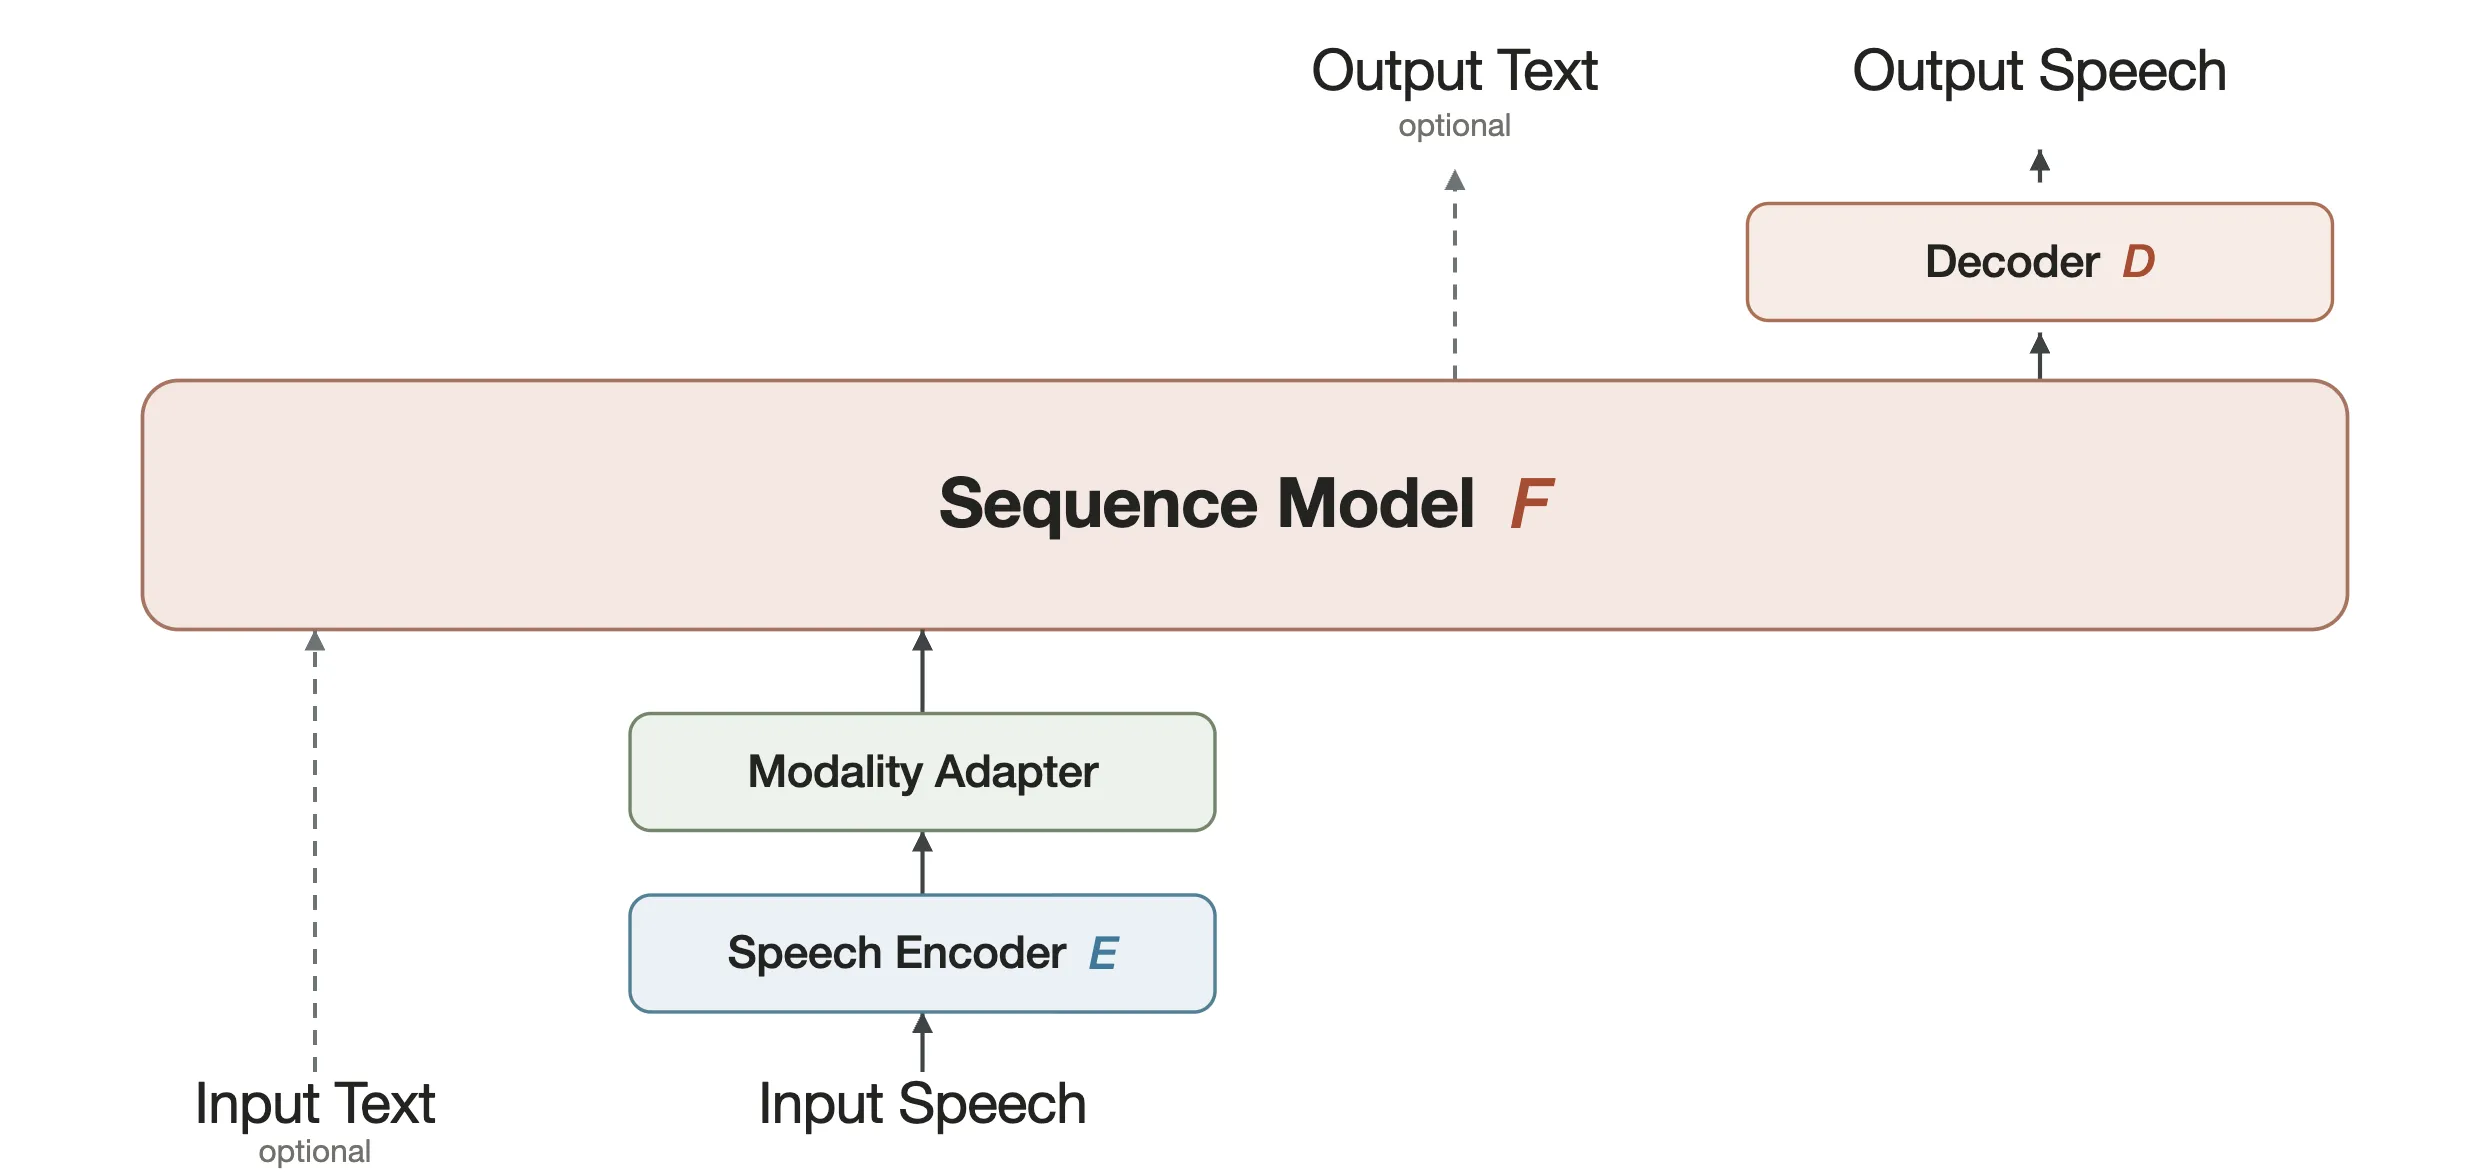
Section titled “E A F D 的统一视角”| 模块 | 系统角色 | 输入和输出 |
|---|---|---|
| Speech Encoder E | 将语音转换成表示 | Input Speech → speech representation |
| Modality Adapter A | 将 Encoder 输出接入 Sequence Model 的输入空间 | speech representation → F 可消费的表示 |
| Sequence Model F | 组织输入输出流,建模上下文并进行预测 | 输入表示和历史上下文 → 预测目标 |
| Decoder D | 将预测目标还原成可听语音 | 模型输出 → Output Speech |
统一框架的语音主路径是 Input Speech → E → A → F → D → Output Speech。Input Text 和 Output Text 是可选的外部路径,在图中用虚线表示;Decoder D 是独立模块。
5 代表架构和数学视角
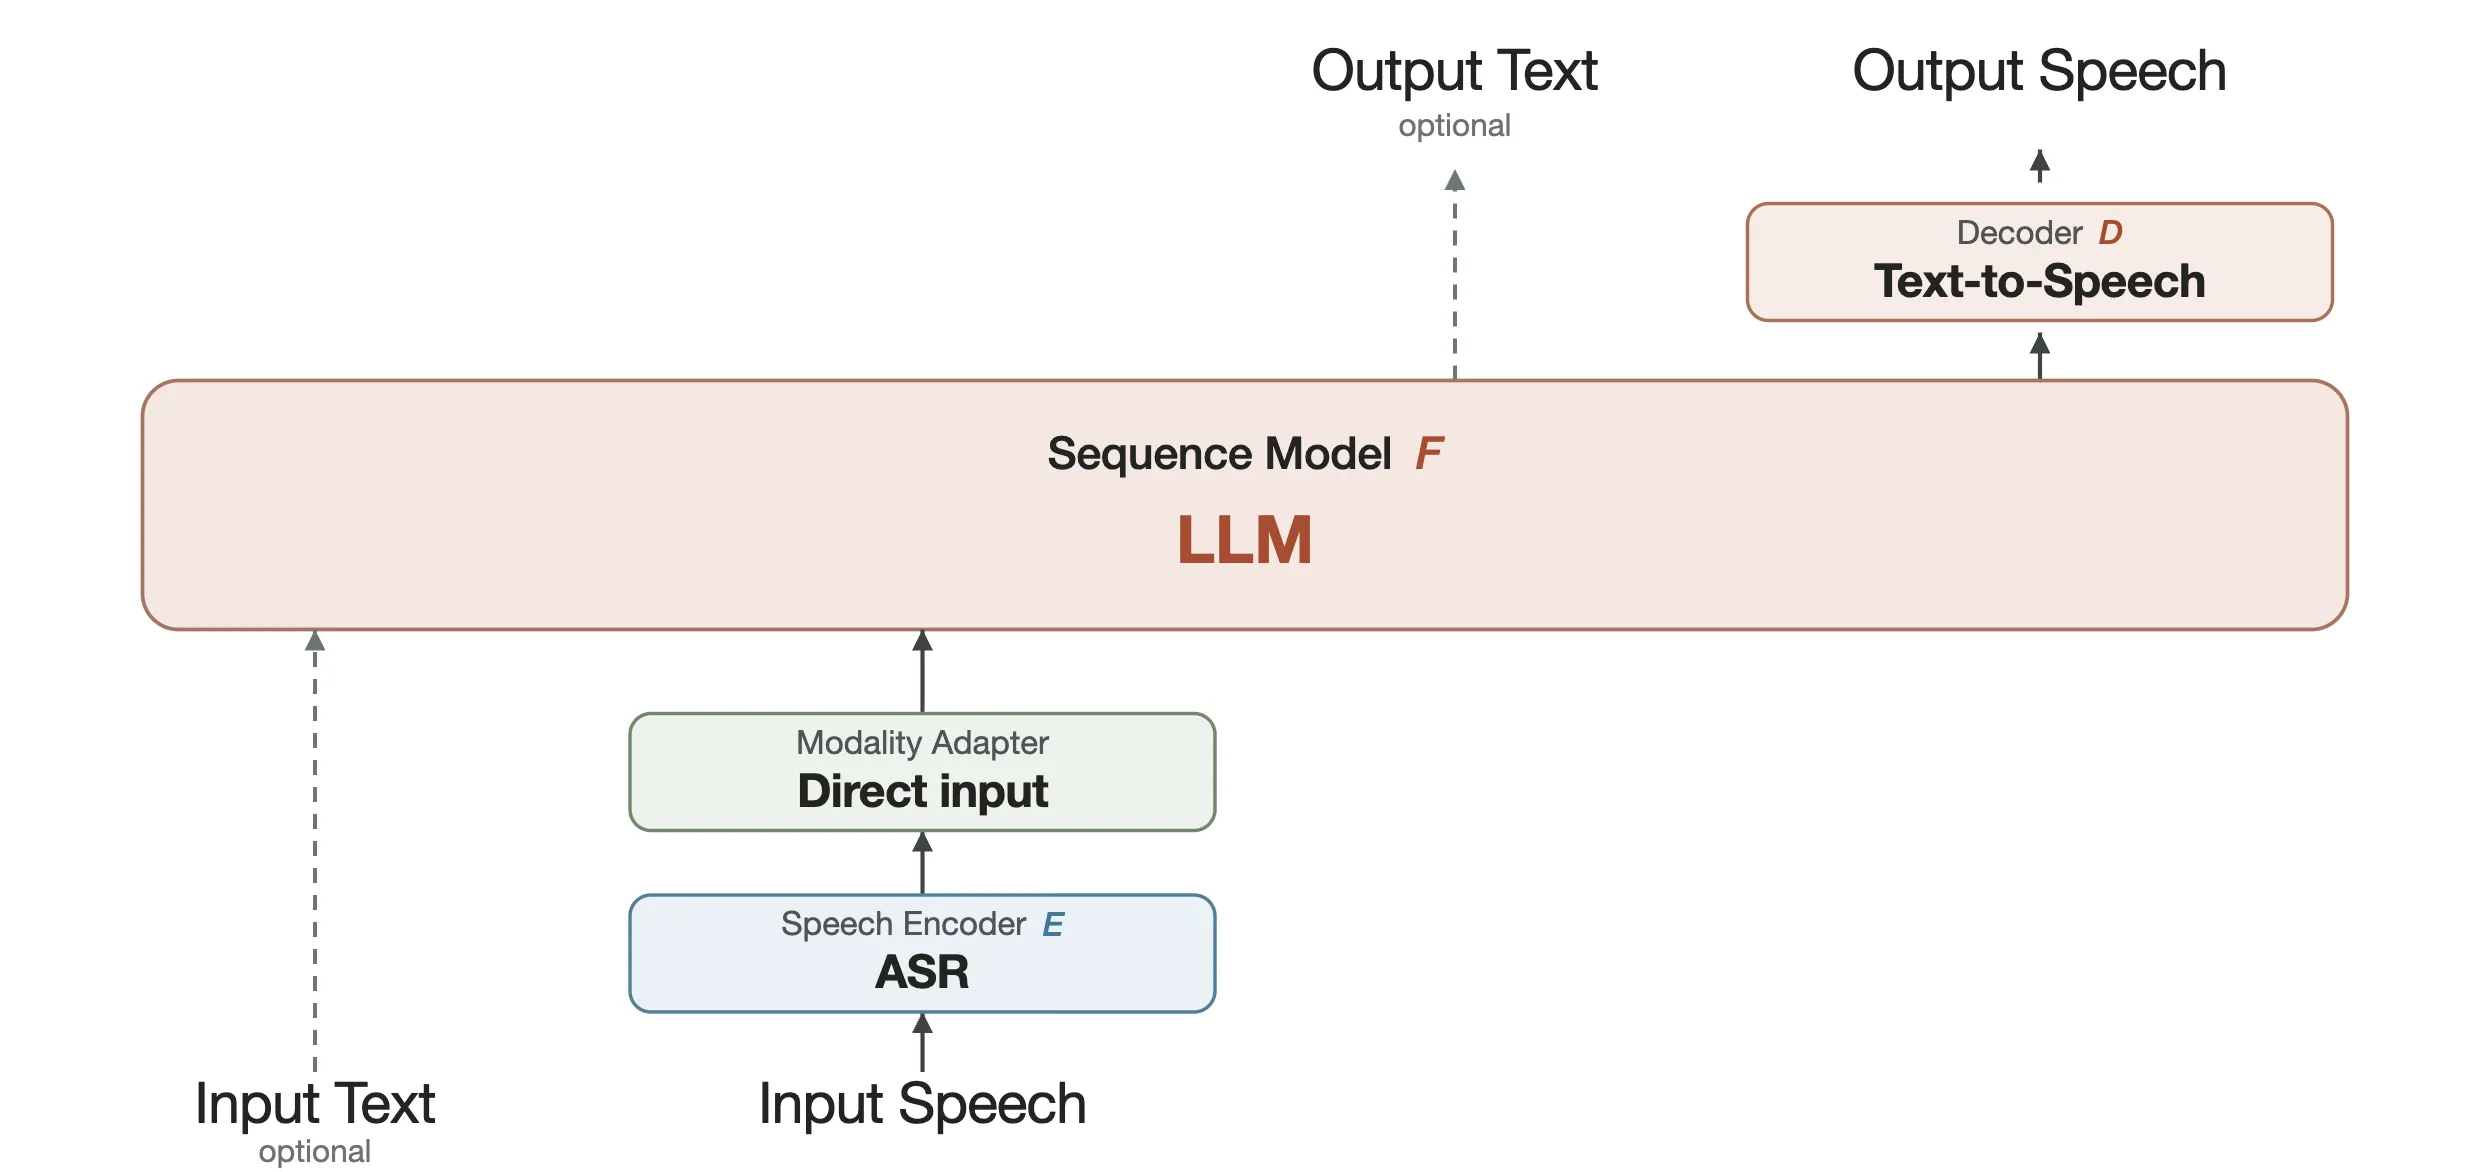
Section titled “5 代表架构和数学视角”级联系统将统一框架实例化为 ASR → LLM → TTS。Encoder E 是 ASR,输出转写文本;Adapter A 是直接输入,表示文本直接进入 LLM 的输入接口,不是额外新增一个学习模块;Sequence Model F 是 LLM;Decoder D 是 TTS。
LLM 到 TTS 的语音主路径通过生成文本衔接。图中的可选外部文本输入输出仍然使用虚线。
两条物理流和序列化文本块
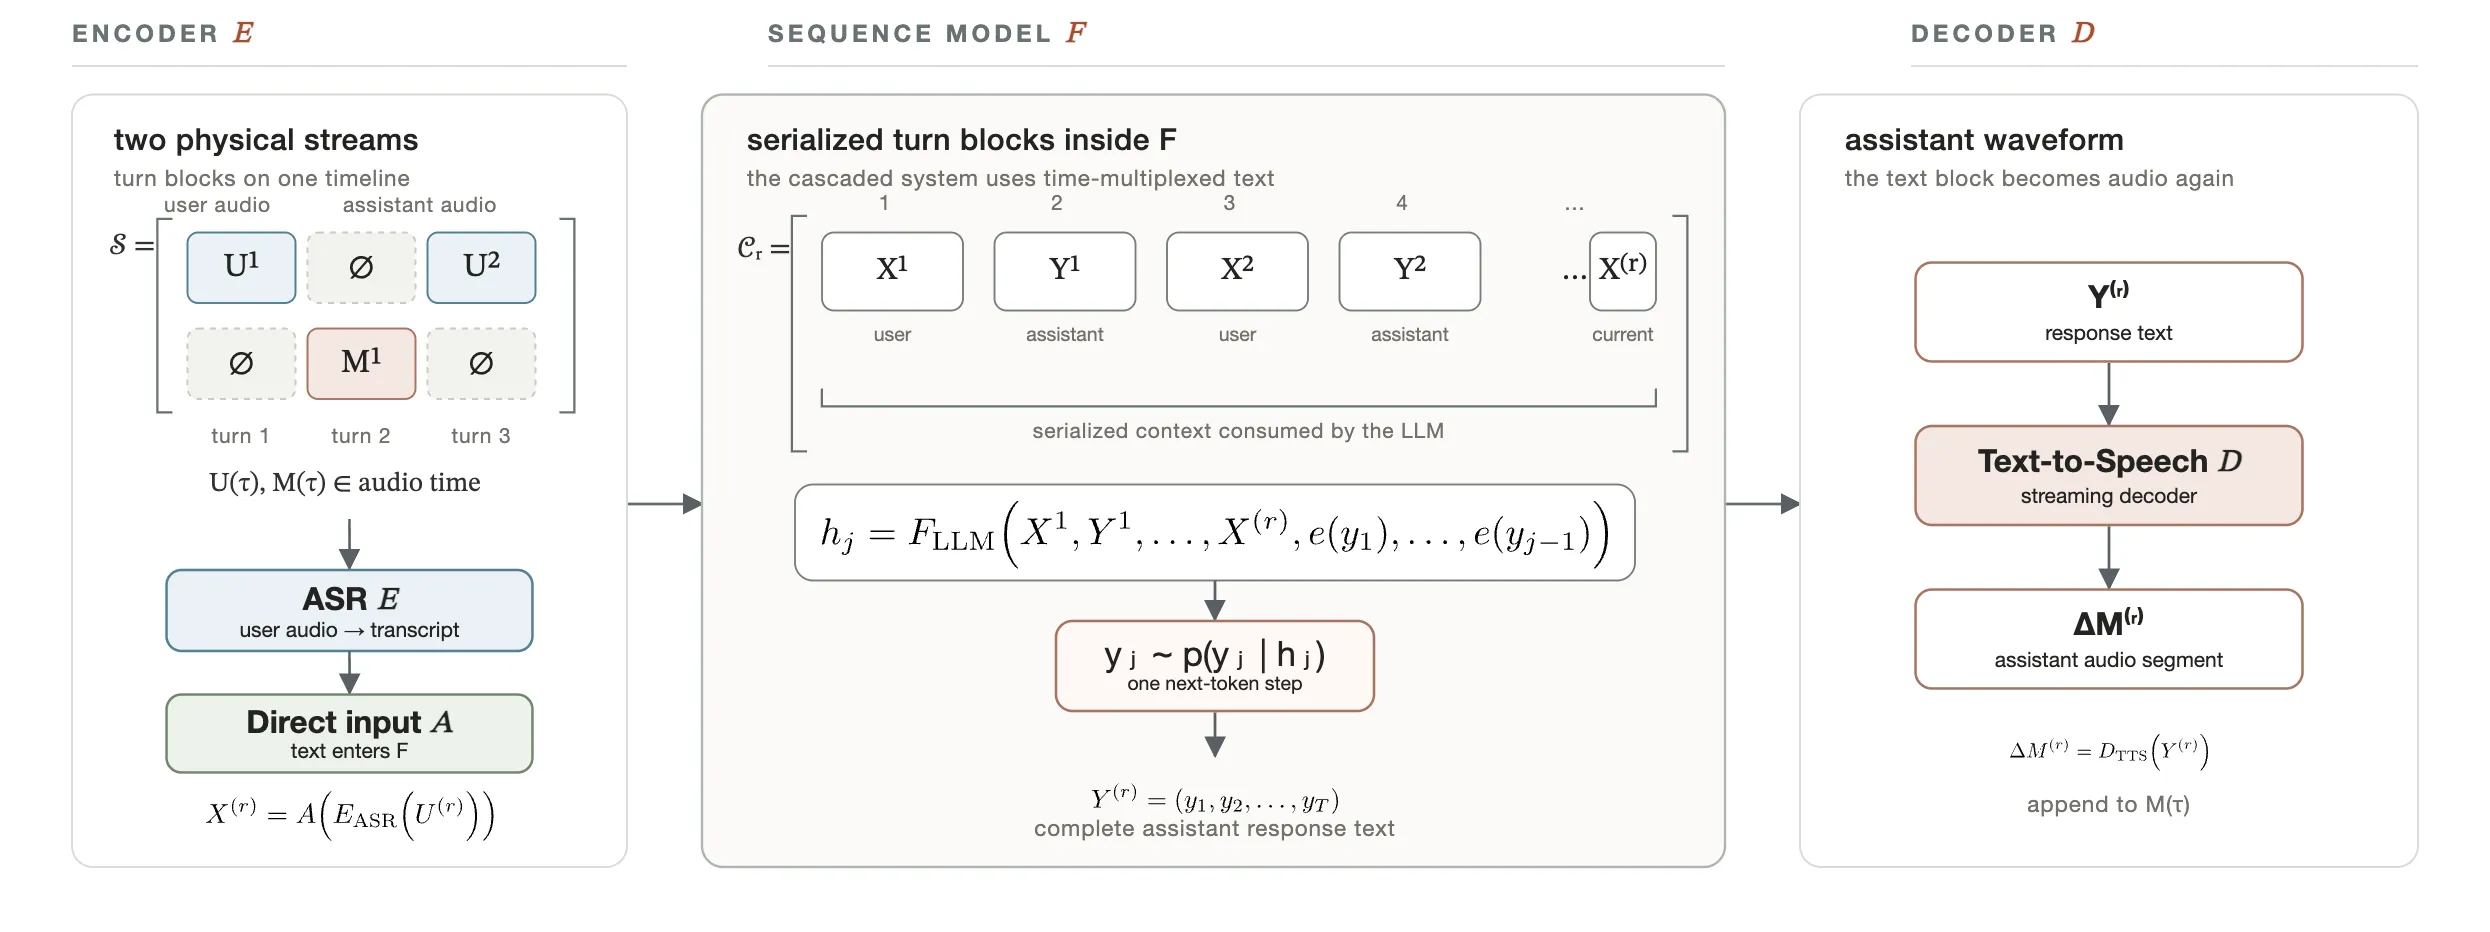
Section titled “两条物理流和序列化文本块”U(τ) 与 M(τ) 表示用户和助手在物理时间中的音频流。按话轮块观察时,可以用两行矩阵表示交替的用户音频 U¹、U² 和助手音频 M¹;没有发声的块用 ∅ 表示。
Encoder 与 Adapter 将第 r 个用户音频块变成模型输入:X⁽ʳ⁾ = A(E_ASR(U⁽ʳ⁾))。进入 F 后,用户文本块和助手文本块按时间复用,形成 Cᵣ = [X¹, Y¹, X², Y², …, X⁽ʳ⁾]。
LLM 消费已有文本块和当前响应的前缀,逐 token 预测:
-
hⱼ = F_LLM(X¹, Y¹, …, X⁽ʳ⁾, e(y₁), …, e(yⱼ₋₁)) -
yⱼ ∼ p(yⱼ | hⱼ) -
Y⁽ʳ⁾ = (y₁, y₂, …, y_T) -
ΔM⁽ʳ⁾ = D_TTS(Y⁽ʳ⁾),生成的助手音频段追加到 M(τ)
Moshi 沿用同一框架:Encoder E 是 Mimi;Adapter A 为空;Sequence Model F 是基于 Helium backbone 的 Temporal Transformer,负责多流音频建模;Decoder D 包括 Depth Transformer 和 Mimi decoder。Inner Monologue(内心独白)是时间对齐的可选文本流。
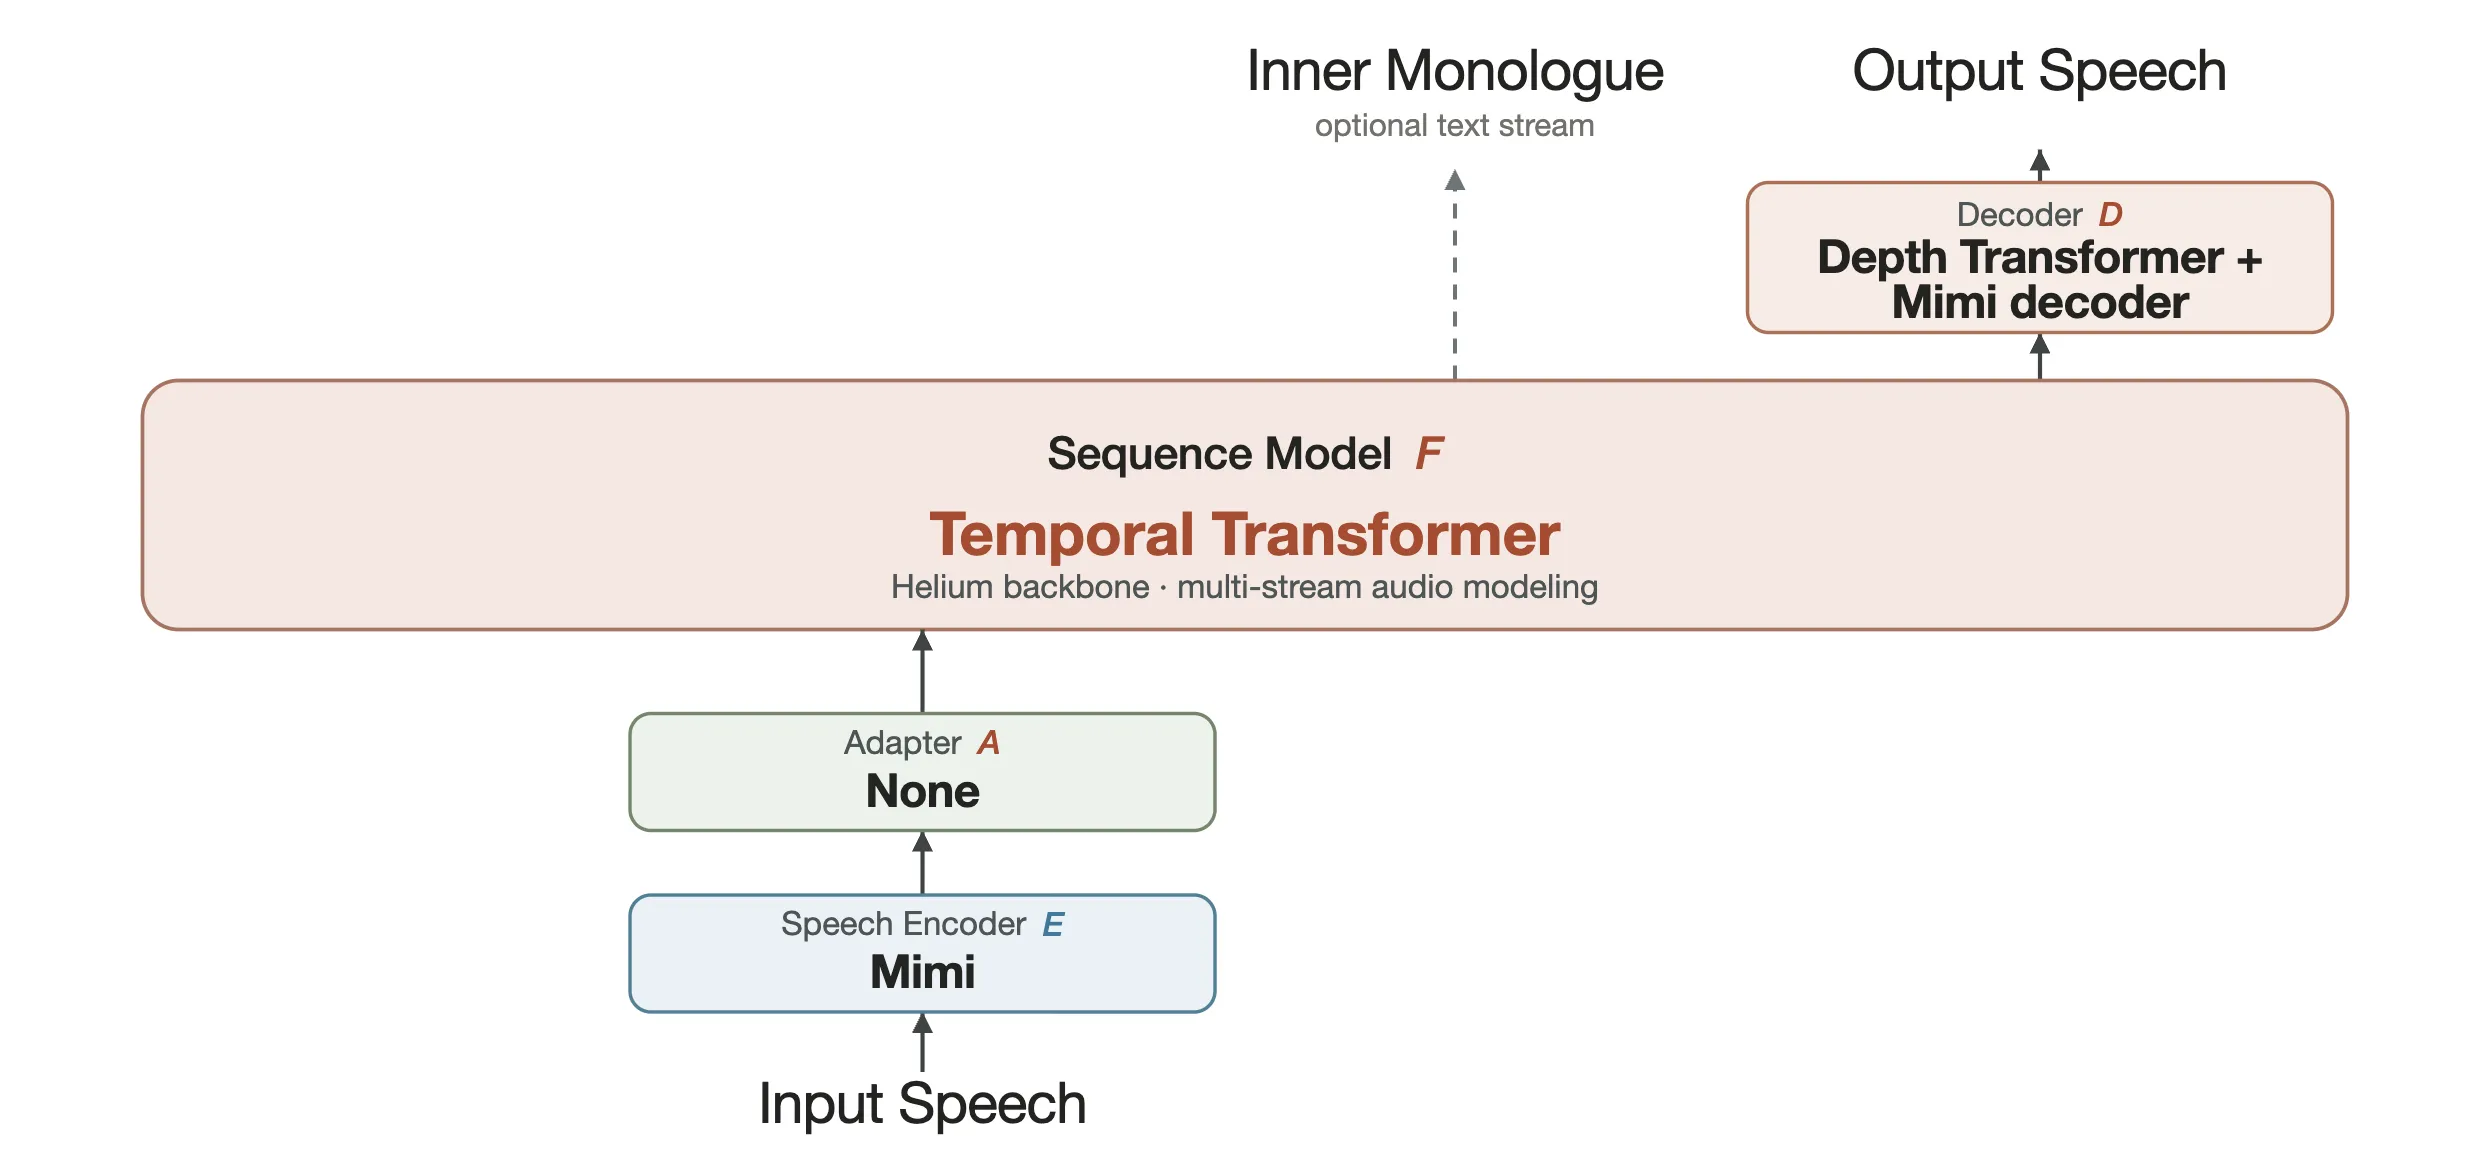
联合列和帧内预测
Section titled “联合列和帧内预测”每个时间步 s 的联合列为 V_s = (V_s,1, …, V_s,K),其中 K = 2Q + 1,图中 Q = 8。列里包含 Inner Monologue 文本 W_s、Moshi 的语义(semantic)和声学(acoustic)codebook,以及用户侧观测到的 codebook。声学 codebook 带有图中所示的延迟 τ,需要按实际音频帧重新对齐。
Temporal Transformer 只消费过去的联合列:z_s = Tr_Temp(V₀, …, V_s−1)。当前用户通道 A′_s 不作为这一步的额外当前参数;用户音频以观测到的 codebook 进入联合流。
Temporal Transformer 的 text head 先预测 W_s ∼ softmax(L_text z_s)。L_text 是将 z_s 映射到文本 token logits 的可学习输出头,不是另一层序列模型。随后 Depth Transformer 消费 W_s 和 z_s,依次预测 Moshi 的语义与声学 codebook:ℓ_s,k = Tr_Depth(z_s, V_s,1, …, V_s,k−1),其中 2 ≤ k ≤ Q + 1,V_s,1 = W_s。
ℓ_s,k 是用于展开帧内依赖的 Depth hidden state,表示第 s 个时间步第 k 个 codebook 的预测状态。用户通道来自麦克风,是观测流,不是 Depth Transformer 的采样输出。最终 Mimi decoder 只将对齐后的 Moshi codebook 还原成助手语音。
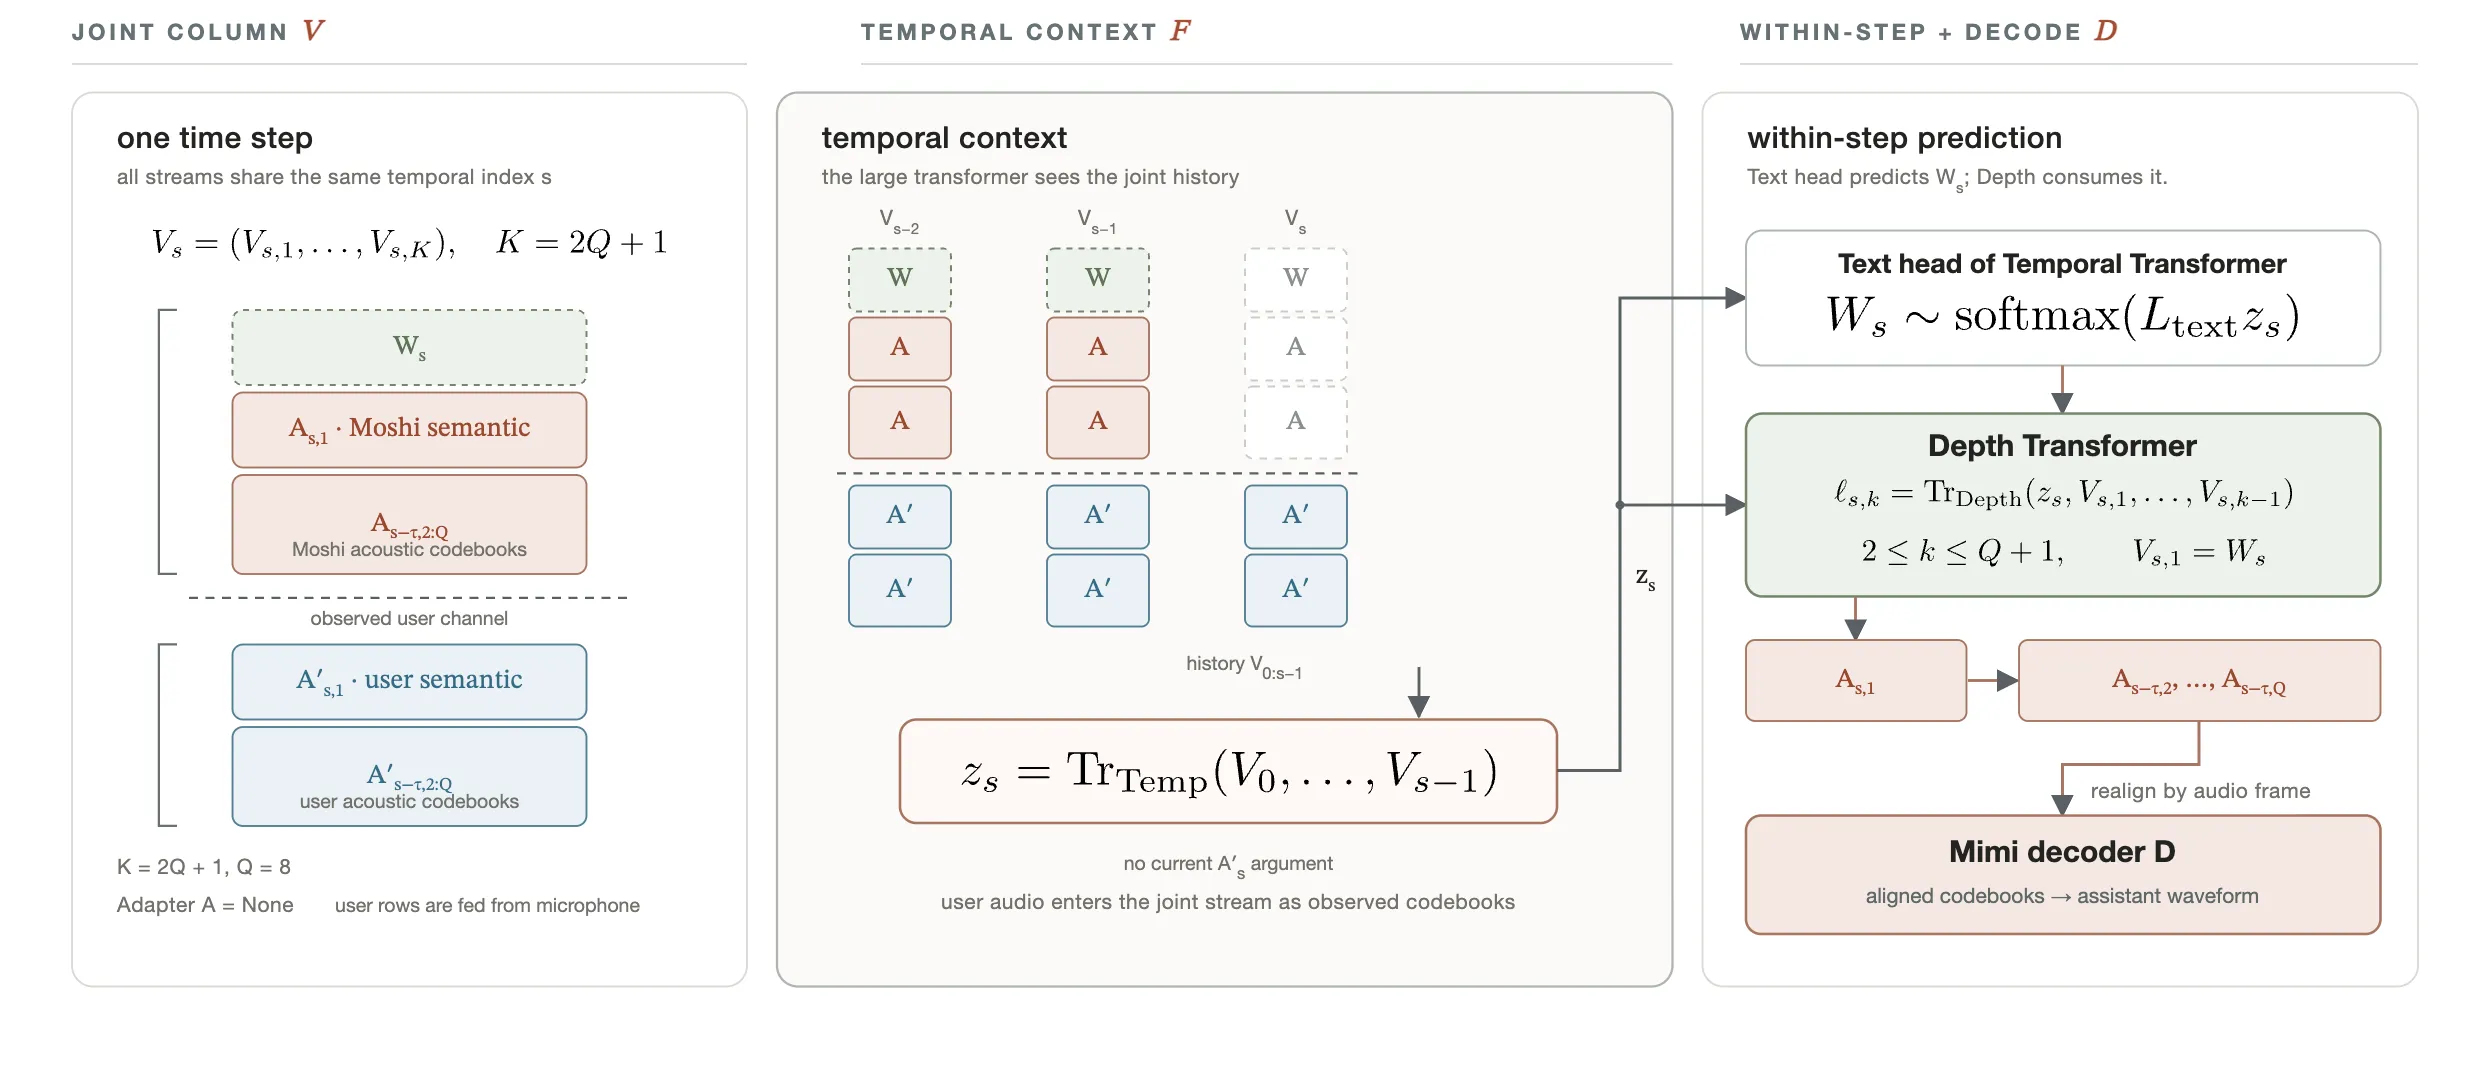
资料:Moshi 论文。
Qwen3-Omni Thinker–Talker
Section titled “Qwen3-Omni Thinker–Talker”这里只展开 AuT 音频路径。Encoder E 是 AuT;Adapter A 是隐藏层投影;Thinker 是统一视角中的 Sequence Model F;Decoder D 由 Talker、MTP 和 Code2Wav 组成。其他输入模态暂不展开。
Thinker 向 Talker 提供助手文本条件和用户音频的隐藏状态。Talker 还会读取自己的助手 codec 历史。这三种输入需要分开理解。
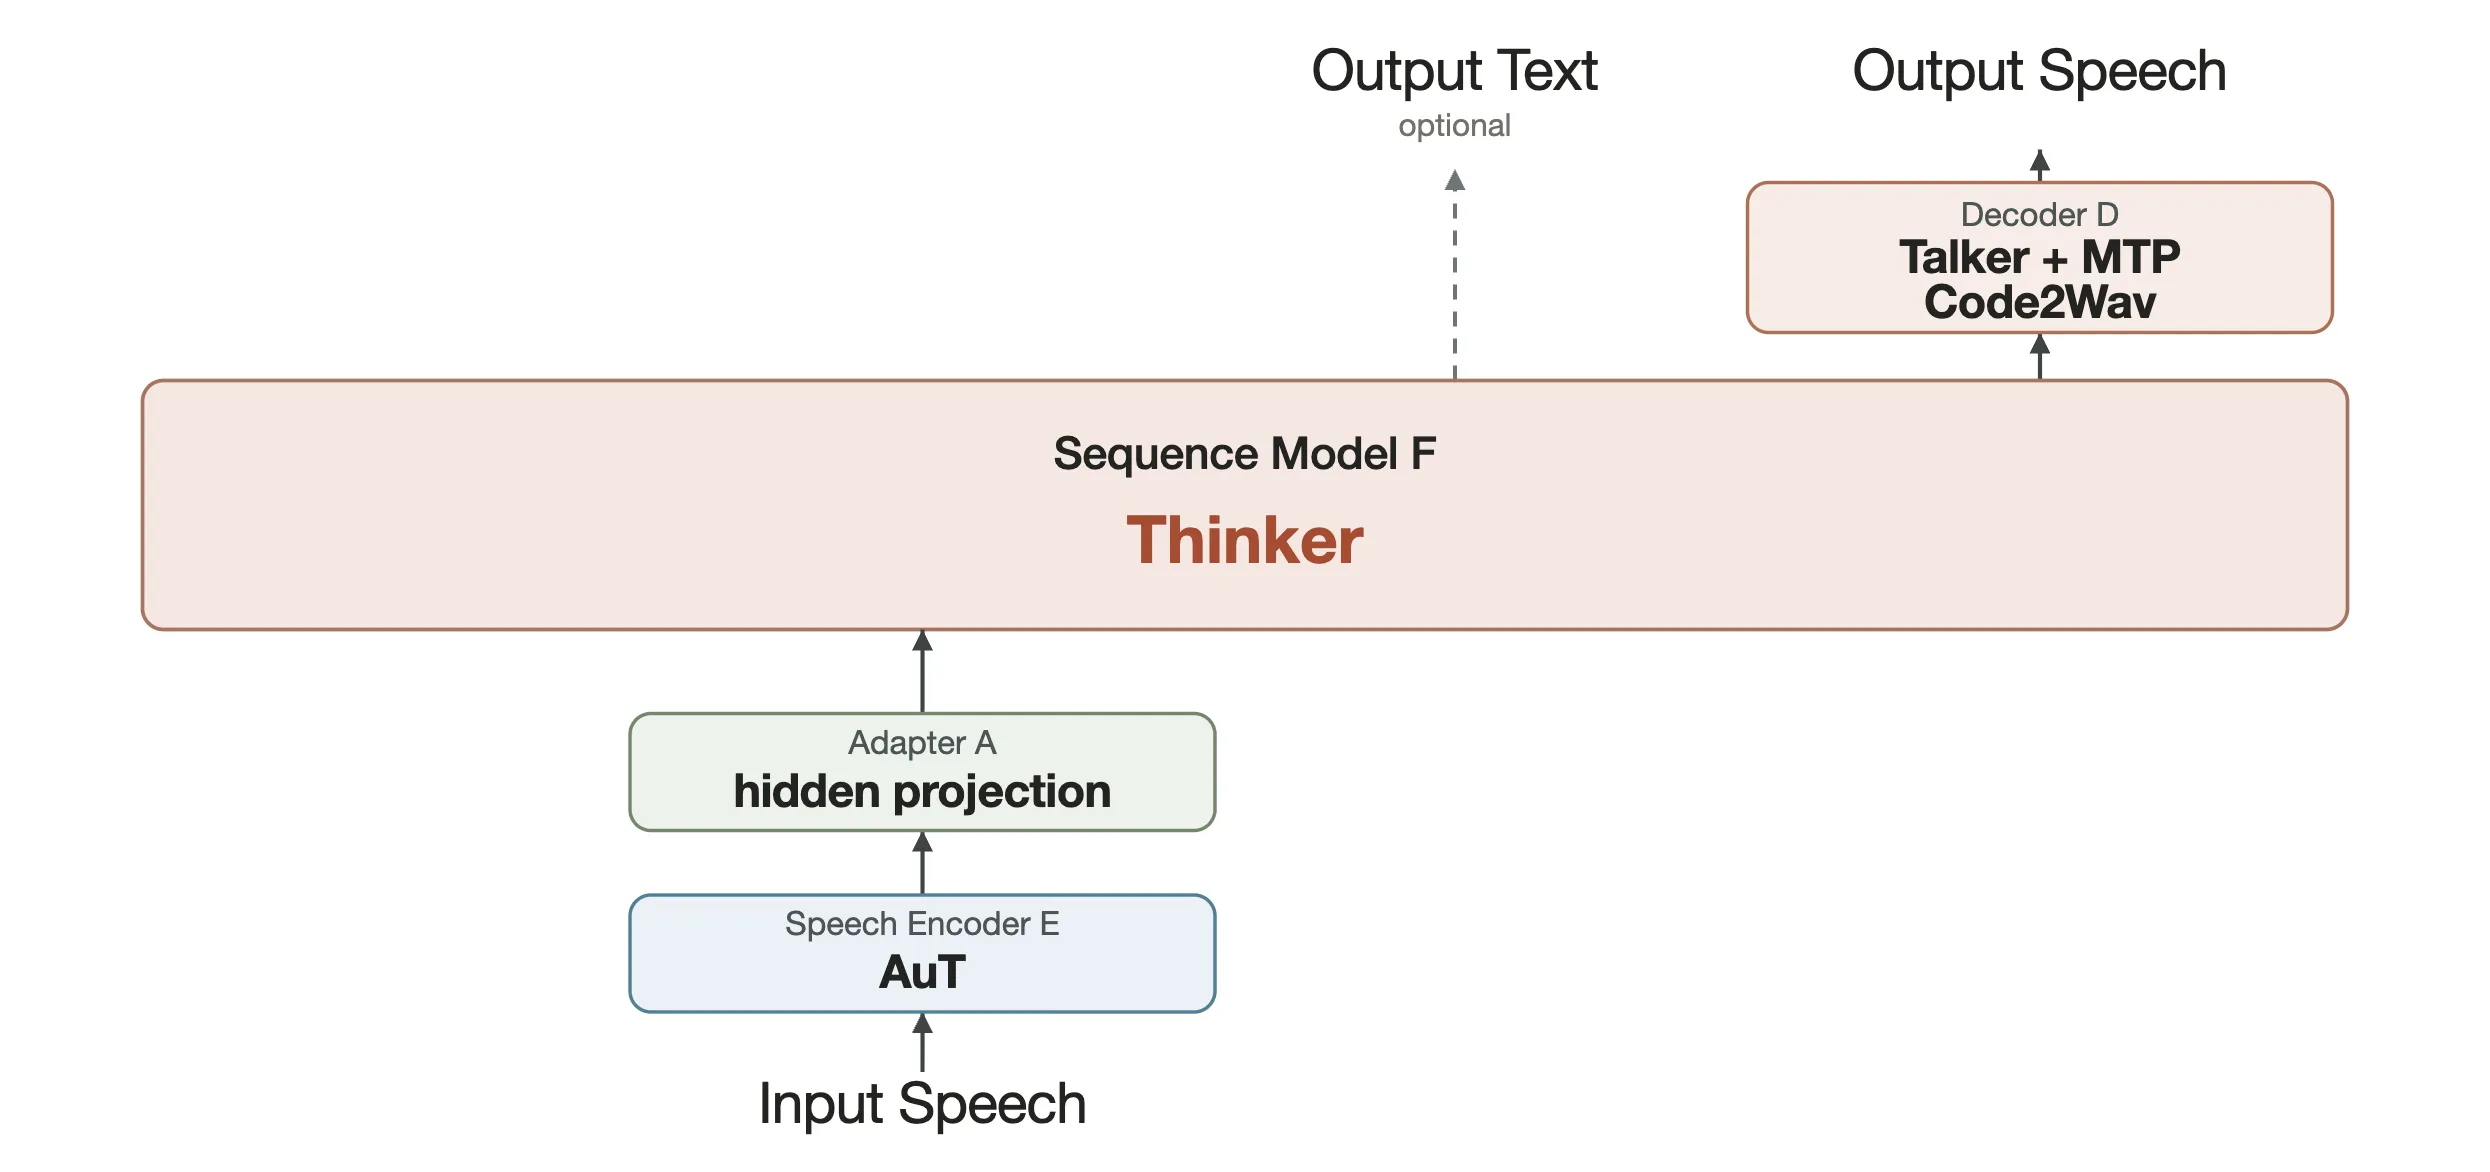
Thinker 的两条输出路径
Section titled “Thinker 的两条输出路径”用户音频首先变成 Thinker 的音频上下文:Zᵘ = A(E_AuT(U))。Thinker 使用 hⱼᵀ = F_Thinker(H_past, Zᵘ, y_<j),一条路径产生助手文本 yⱼ,另一条路径产生 bᵘᵢ = P_mm hᵀᵢ 形式的用户上下文状态。
Talker 的前缀和帧生成
Section titled “Talker 的前缀和帧生成”S_ctrl 是由 speaker_id 与 TTS/codec 控制 token 组成的控制前缀,不是另一组隐藏状态。文本通过 ηⱼ = P_text e(yⱼ) 进入 Talker。每一步还读取上一帧的助手 codec embedding:zᵃ_t = η_t + Σₖ eₖ(m_t−1,k)。
Talker 的声学步骤消费用户上下文 Bᵘ、S_ctrl、zᵃ_t 和 η 的历史。随后先预测首个 codebook,再由 MTP 补齐同一帧的残差 codebook,形成完整的助手 codec 帧 m_t = (m_t,1, …, m_t,K);Code2Wav 使用 codec 帧及其历史还原波形。依赖关系是首个 codebook → MTP 残差 → 波形。
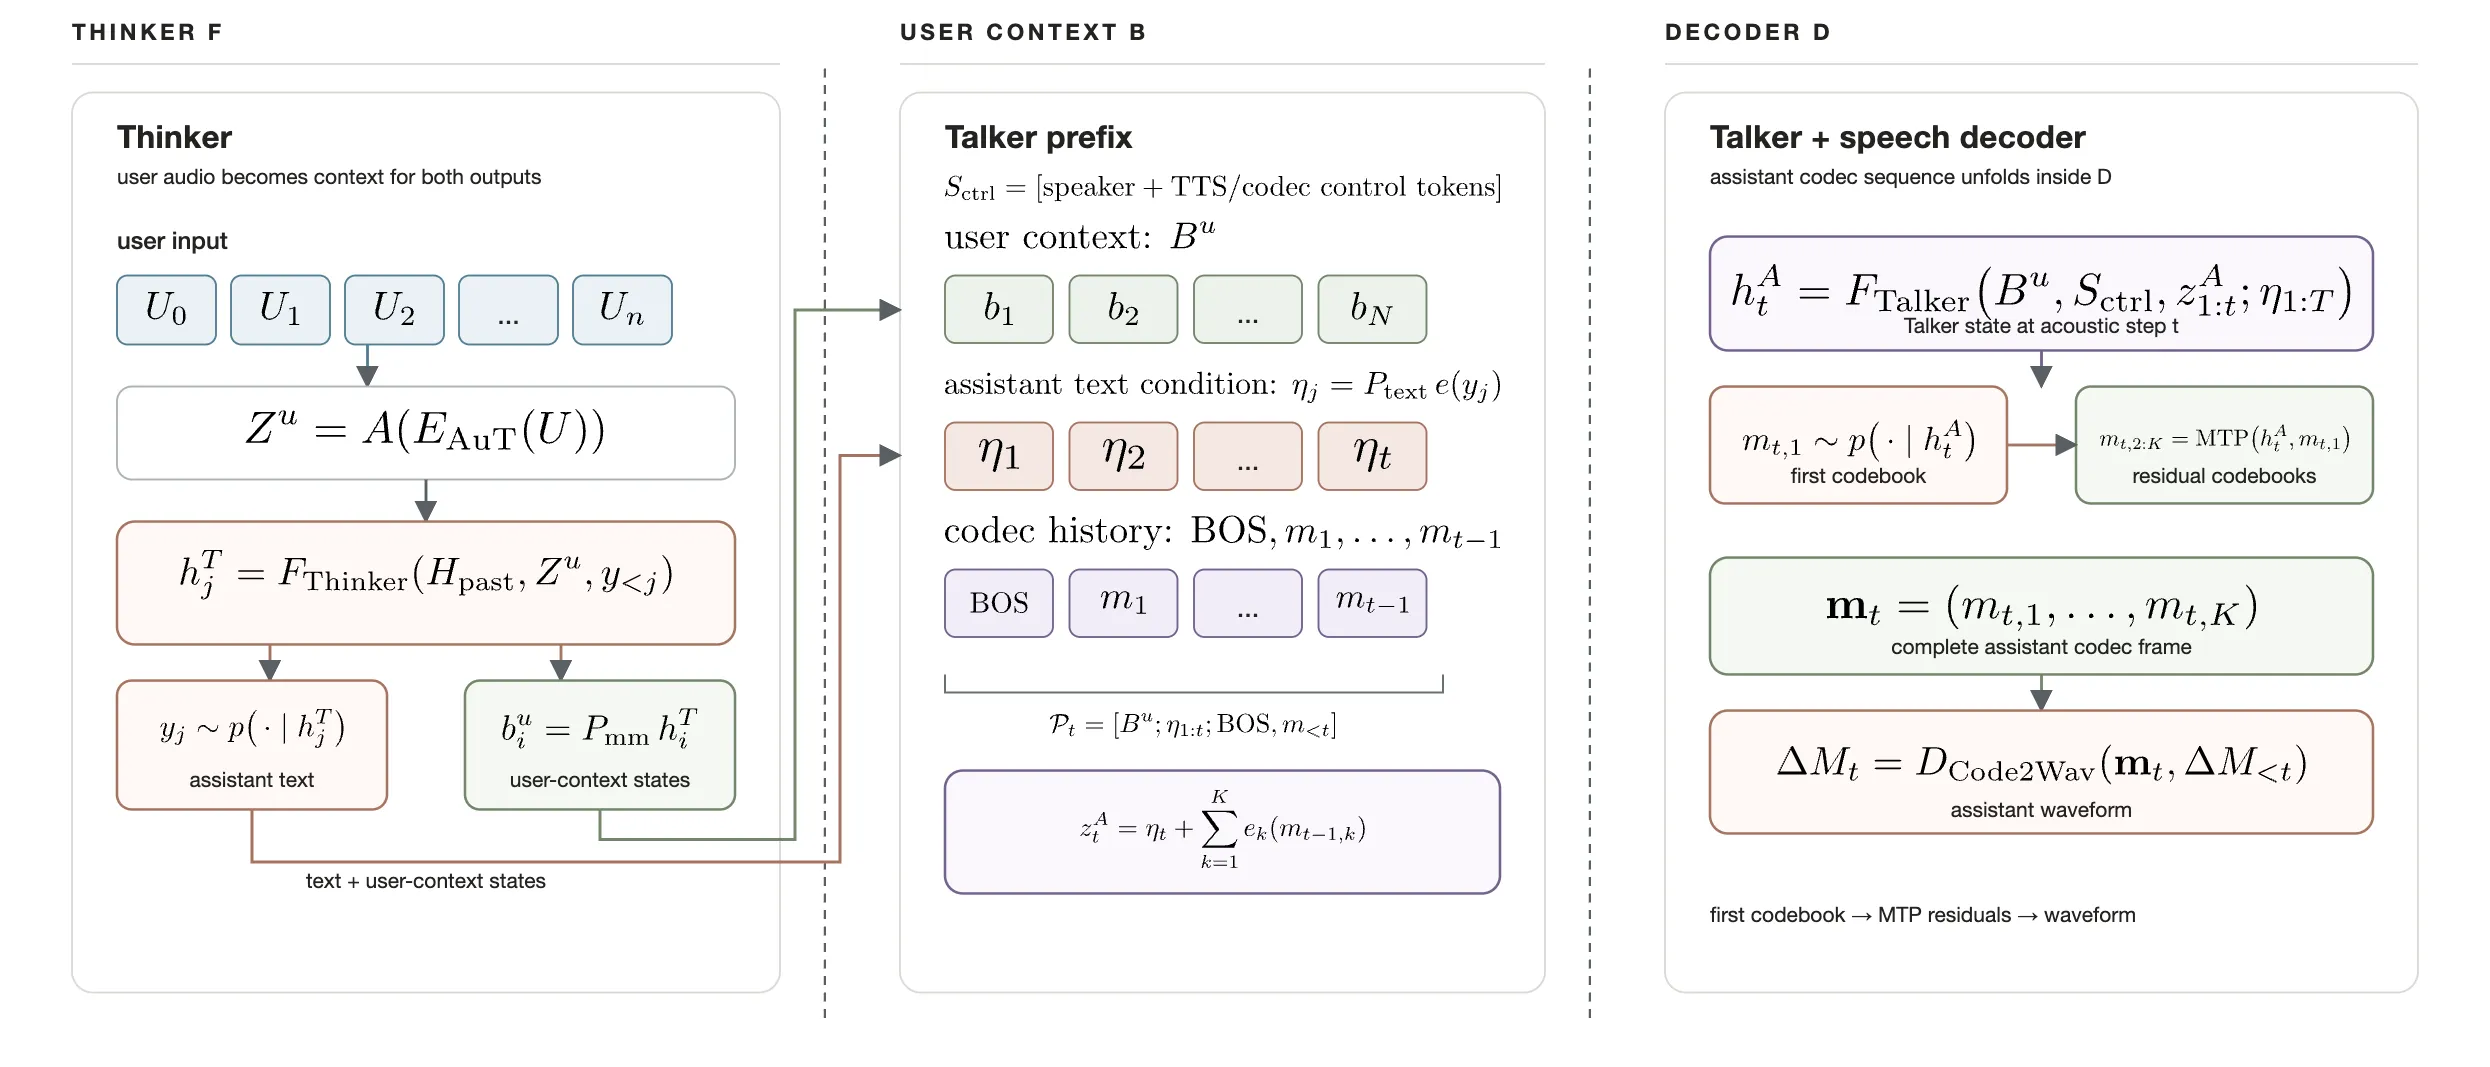
资料:Qwen3-Omni 官方仓库、技术报告。
Thinking Machines Lab Interaction Model
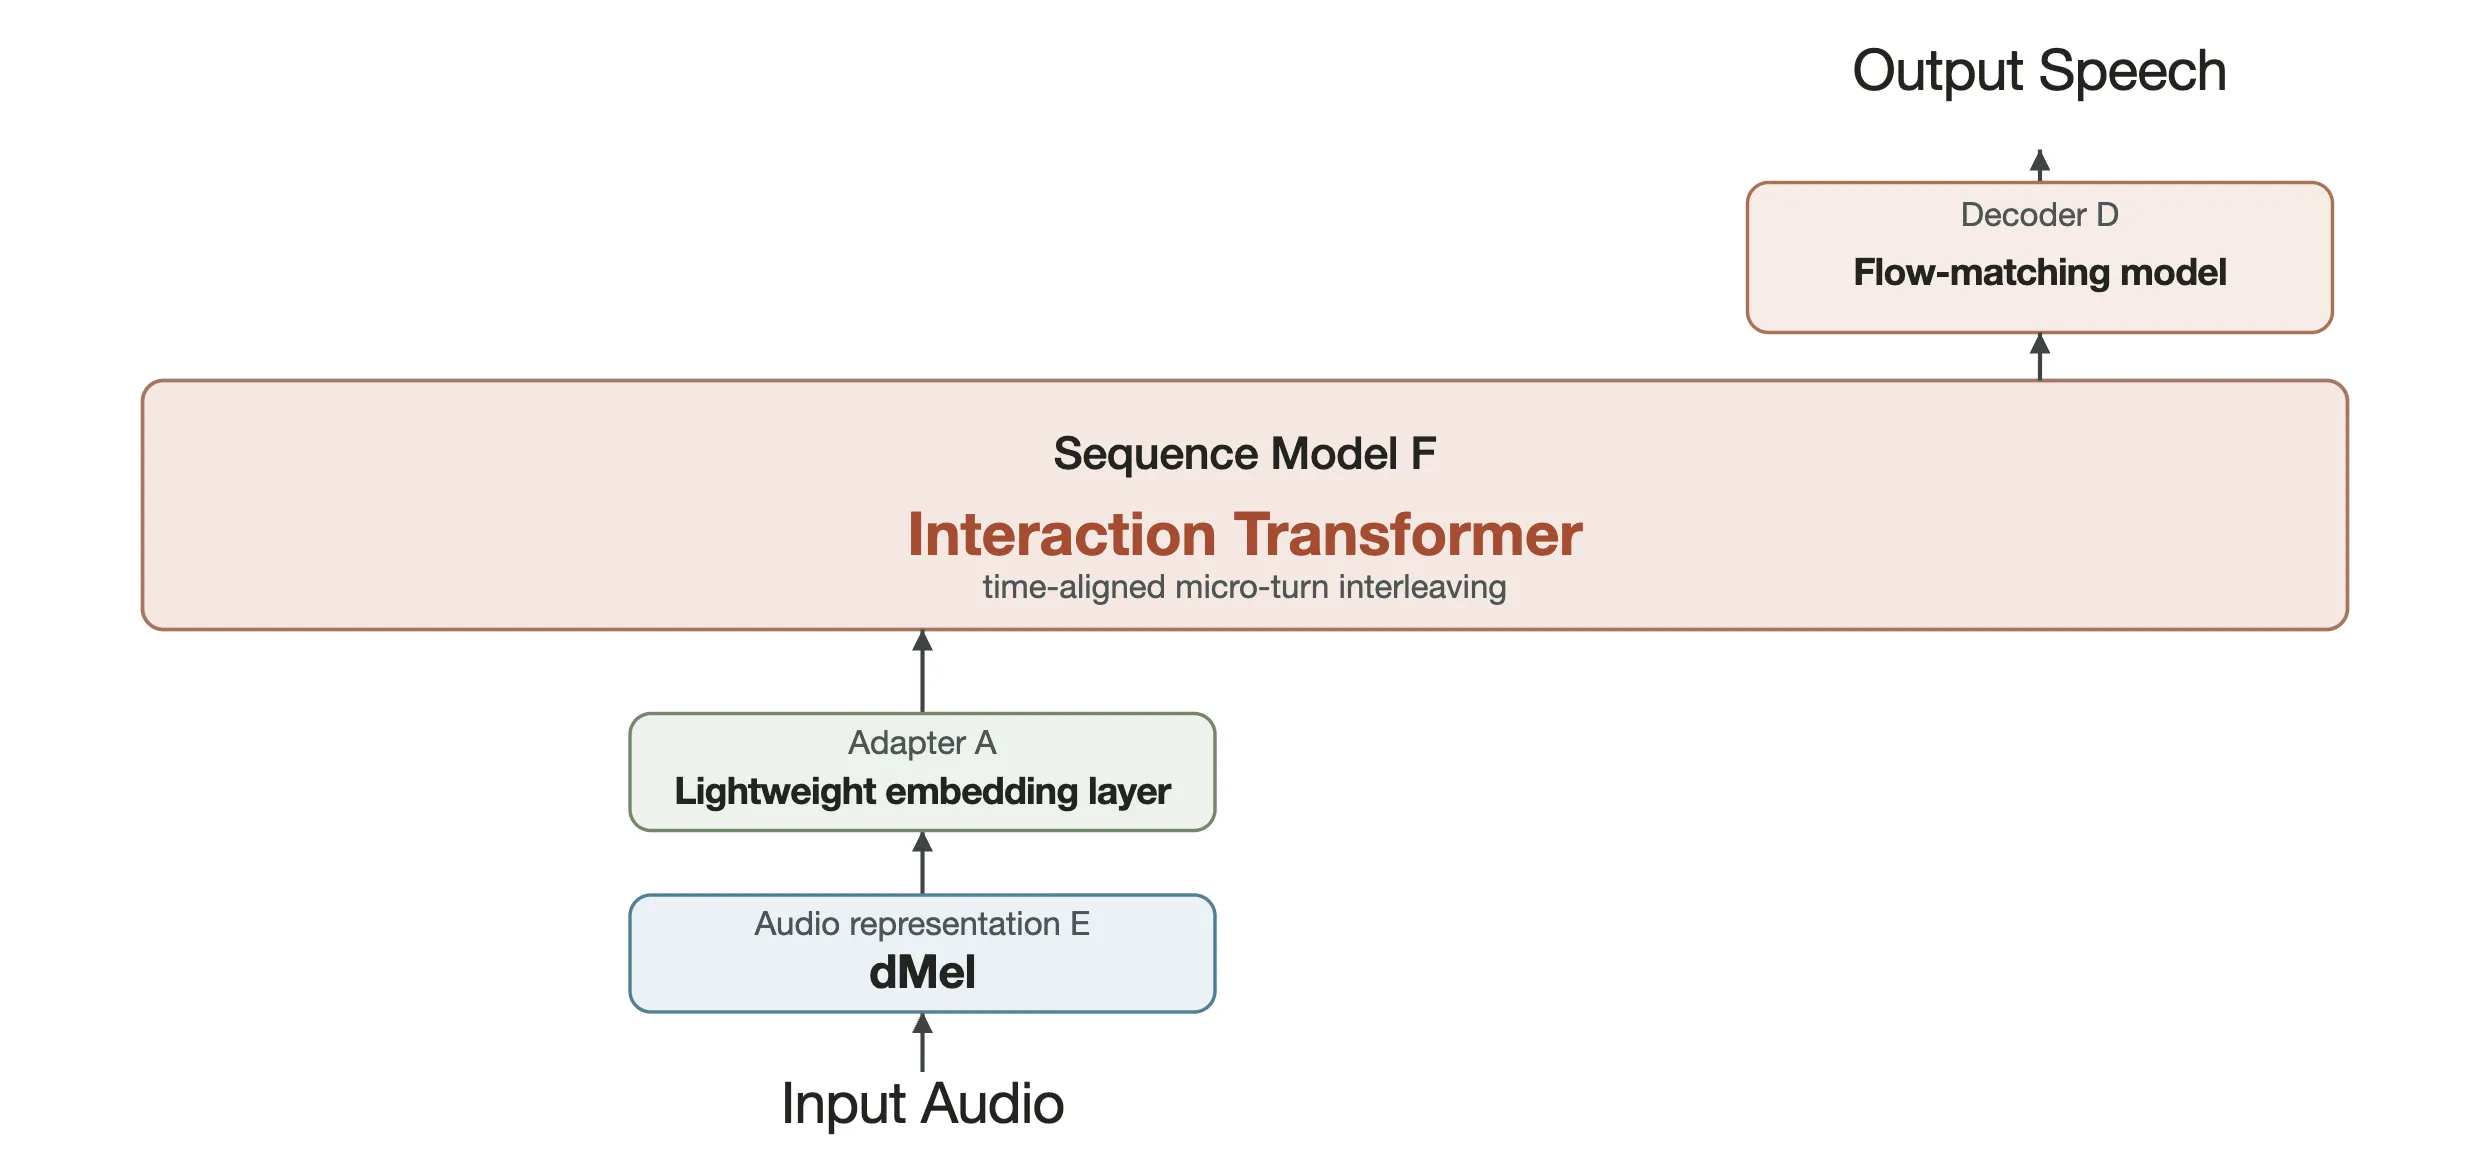
Section titled “Thinking Machines Lab Interaction Model”架构只实例化官方 Interaction Models 文章明确披露的音频路径:Encoder E 是 dMel 音频表示;Adapter A 是轻量的 embedding 层;Sequence Model F 是 Interaction Transformer;Decoder D 是 flow-matching 模型。视频分支暂不展开,文本输出头不放进语音生成路径。
200 ms 微话轮的时间组织
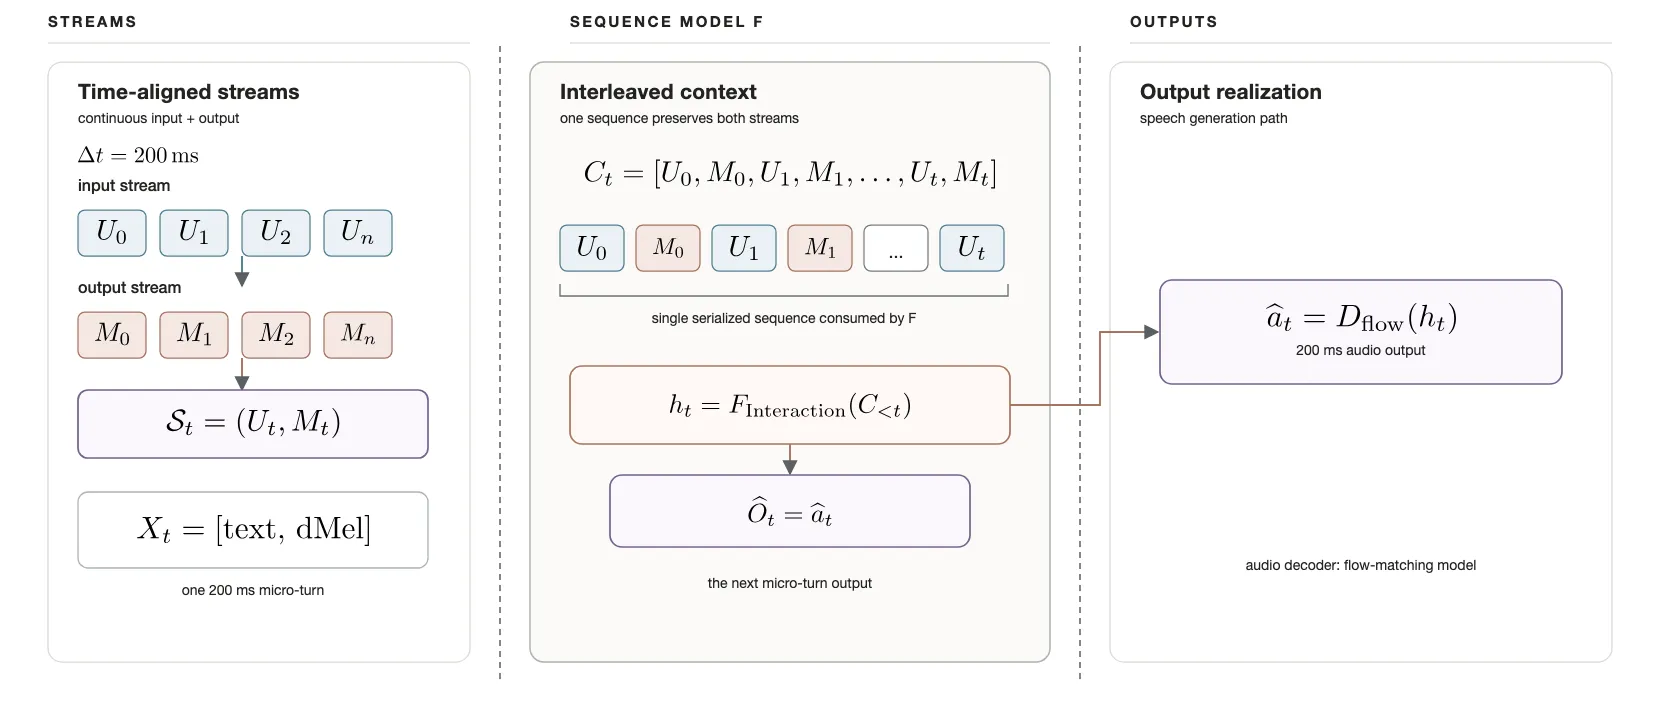
Section titled “200 ms 微话轮的时间组织”连续输入和输出按 Δt = 200 ms 切成时间对齐的微话轮(micro-turn)块。每个对齐片段可写为 S_t = (U_t, M_t),再交错为一个序列:C_t = [U₀, M₀, U₁, M₁, …, U_t, M_t],供 Interaction Transformer 消费。
图中 X_t 保留 [text, dMel];模型状态写为 h_t = F_Interaction(C_t);语音输出只抽象表示为 â_t = D_flow(h_t)。文章没有公开更多可以可靠展开的内部依赖,其余部分保持抽象。文章还提到了文本预测与音频 flow 输出头,这里不据此补充未披露的内部算法。
资料:Thinking Machines Lab Interaction Models。
6 统一框架中的设计空间
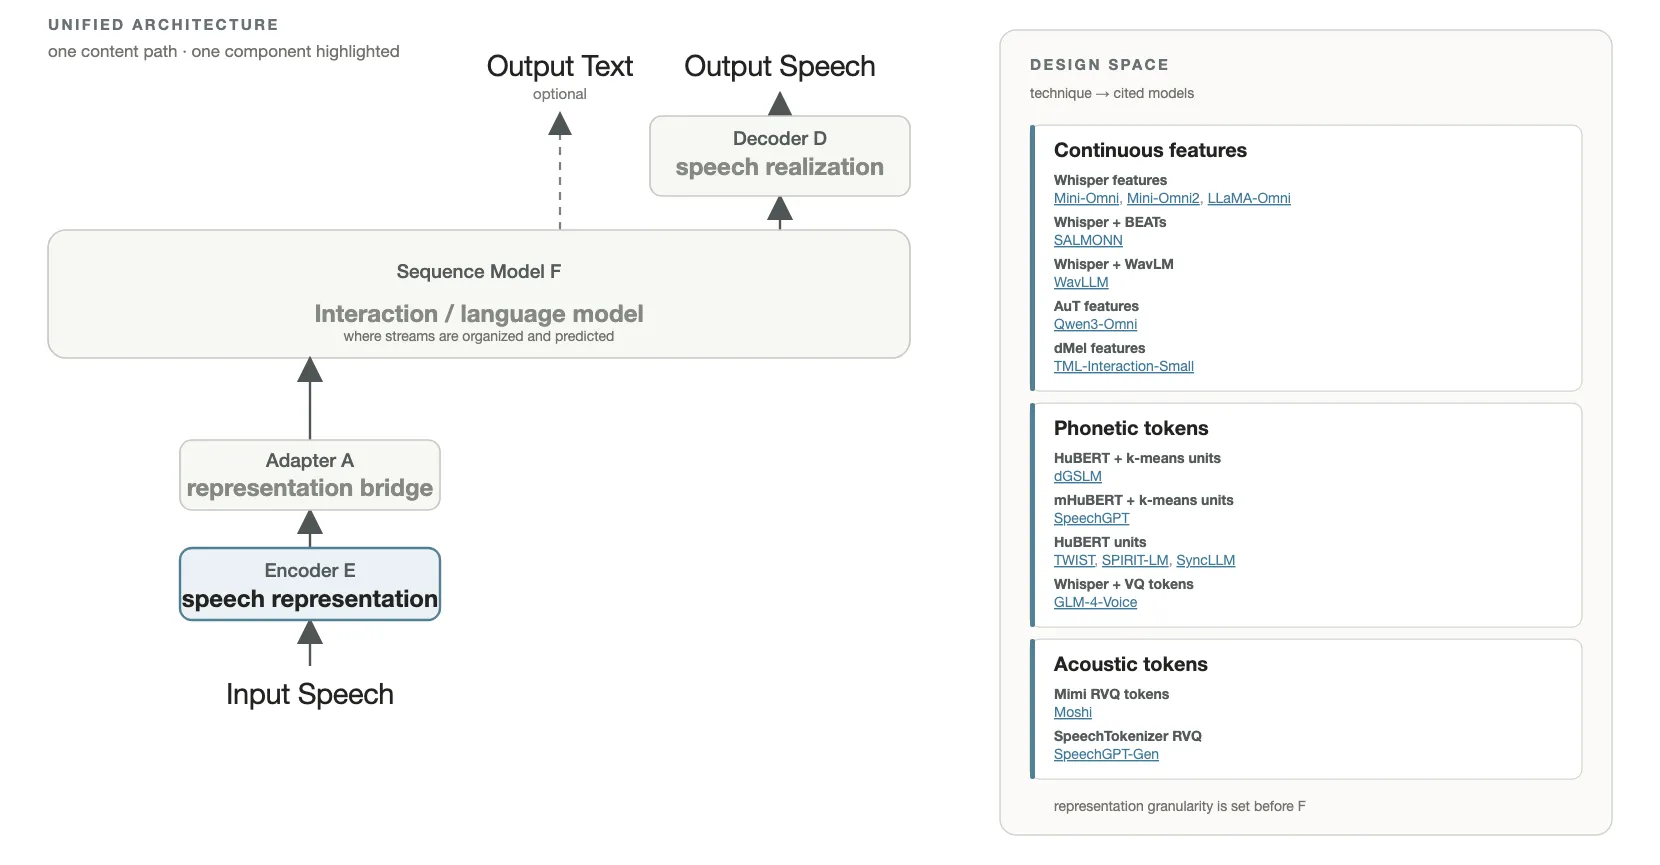
Section titled “6 统一框架中的设计空间”本节固定 E → A → F → D 的框架,分别观察各模块可采用的技术与模型实例。模型名称链接到对应的论文或官方资料。总体参考:On The Landscape of Spoken Language Models A Comprehensive Survey。
Encoder
Section titled “Encoder”Encoder 将连续波形变成 Sequence Model 可消费的表示,决定进入 F 之前的表示粒度。
| 分类 | 技术 | 模型实例 |
|---|---|---|
| 连续特征 | Whisper features | Mini-Omni、Mini-Omni2、LLaMA-Omni |
| 连续特征 | Whisper + BEATs | SALMONN |
| 连续特征 | Whisper + WavLM | WavLLM |
| 连续特征 | AuT features | Qwen3-Omni |
| 连续特征 | dMel features | TML-Interaction-Small |
| 语音单元 token | HuBERT + k-means units | dGSLM |
| 语音单元 token | mHuBERT + k-means units | SpeechGPT |
| 语音单元 token | HuBERT units | TWIST、SPIRIT-LM、SyncLLM |
| 语音单元 token | Whisper + VQ tokens | GLM-4-Voice |
| 声学 token | Mimi RVQ tokens | Moshi |
| 声学 token | SpeechTokenizer RVQ | SpeechGPT-Gen |
Adapter
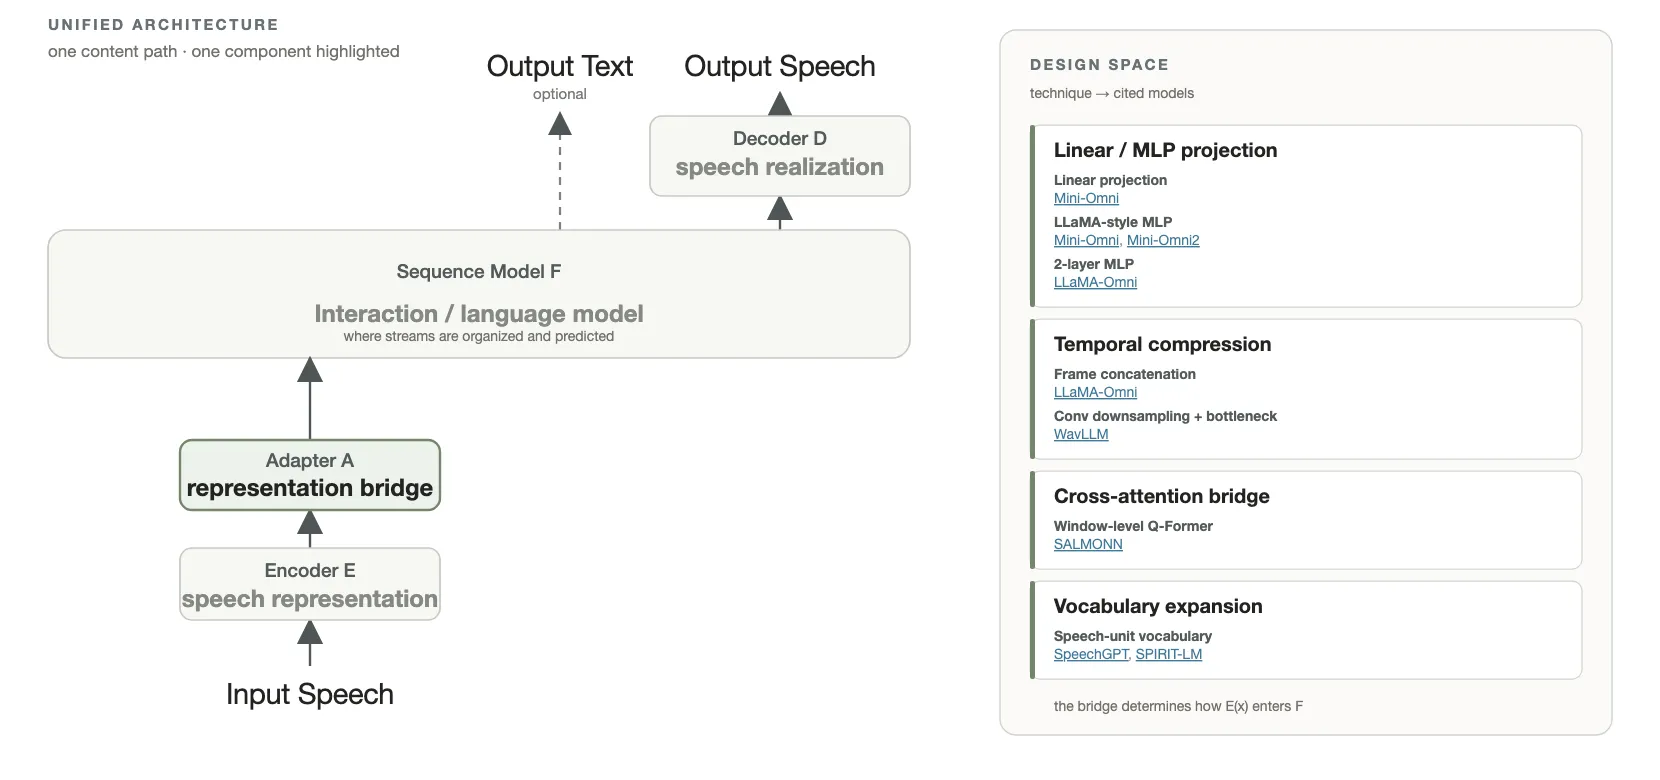
Section titled “Adapter”Adapter 将 Encoder 输出对齐到 Sequence Model 的输入空间,决定 E(x) 如何进入 F。
| 分类 | 技术 | 模型实例 |
|---|---|---|
| 线性或 MLP 投影 | 线性投影 | Mini-Omni |
| 线性或 MLP 投影 | LLaMA-style MLP | Mini-Omni、Mini-Omni2 |
| 线性或 MLP 投影 | 两层 MLP | LLaMA-Omni |
| 时间压缩 | 帧拼接 | LLaMA-Omni |
| 时间压缩 | 卷积下采样 + 瓶颈层 | WavLLM |
| 交叉注意力桥接 | 窗口级 Q-Former | SALMONN |
| 词表扩展 | 语音单元词表 | SpeechGPT、SPIRIT-LM |
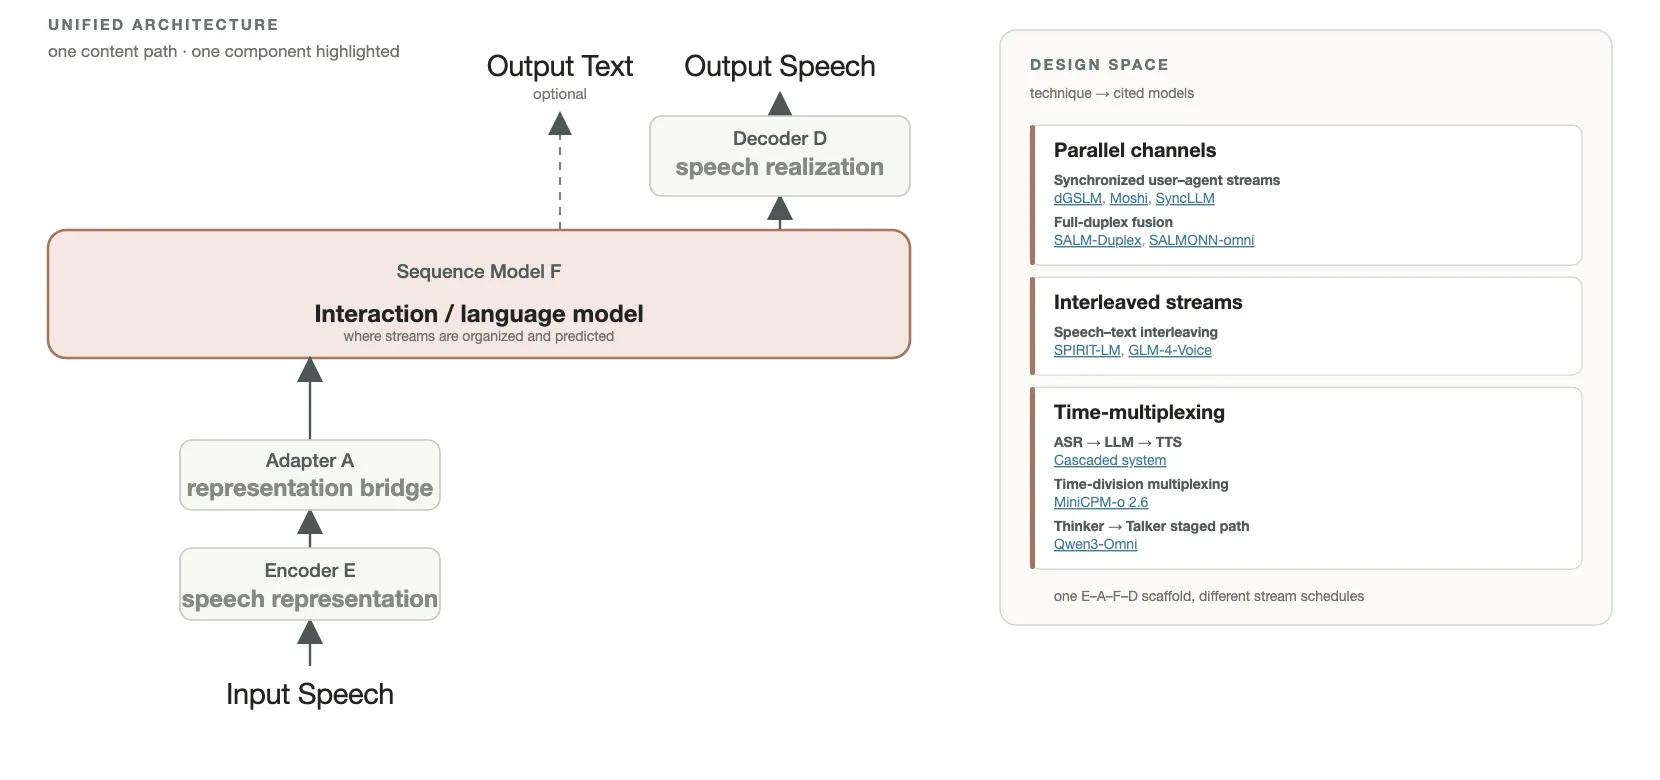
Sequence Model
Section titled “Sequence Model”Sequence Model 决定用户与助手的流如何组织和预测;相同框架可以采用不同的时间调度。
| 分类 | 技术 | 模型实例 |
|---|---|---|
| 并行通道 | 同步的用户—助手流 | dGSLM、Moshi、SyncLLM |
| 并行通道 | 全双工融合 | SALM-Duplex、SALMONN-omni |
| 交错流 | 语音—文本交错 | SPIRIT-LM、GLM-4-Voice |
| 时分复用 | ASR → LLM → TTS | 级联系统 |
| 时分复用 | 时分复用 | MiniCPM-o 2.6 |
| 时分复用 | Thinker → Talker 分阶段路径 | Qwen3-Omni |
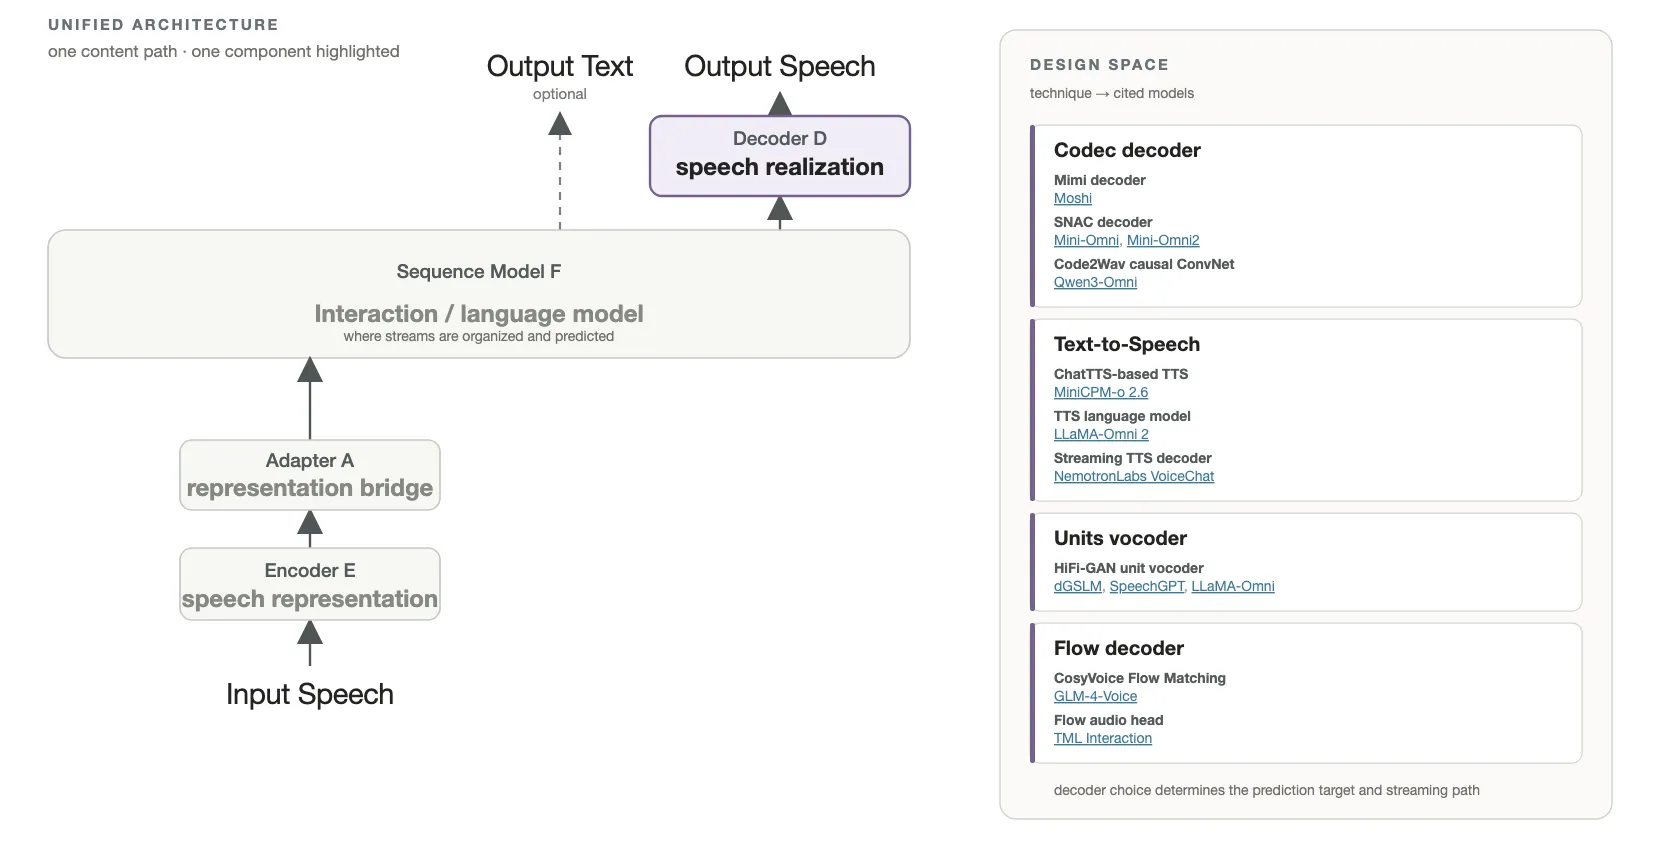
Decoder
Section titled “Decoder”Decoder 将模型的预测目标还原成可听语音;选择会影响预测目标和流式输出路径。
| 分类 | 技术 | 模型实例 |
|---|---|---|
| Codec 解码器 | Mimi decoder | Moshi |
| Codec 解码器 | SNAC decoder | Mini-Omni、Mini-Omni2 |
| Codec 解码器 | Code2Wav causal ConvNet | Qwen3-Omni |
| 语音合成(TTS) | ChatTTS-based TTS | MiniCPM-o 2.6 |
| 语音合成(TTS) | TTS language model | LLaMA-Omni 2 |
| 语音合成(TTS) | Streaming TTS decoder | NemotronLabs VoiceChat |
| 单元声码器 | HiFi-GAN unit vocoder | dGSLM、SpeechGPT、LLaMA-Omni |
| Flow 解码器 | CosyVoice Flow Matching | GLM-4-Voice |
| Flow 解码器 | Flow audio head | TML Interaction |
7 如何建模对话动态
Section titled “7 如何建模对话动态”按照交互控制发生的位置,可以区分三个层级:L0 外部模块系统、L1 隐藏状态桥接、L2 token 级建模。三类都按机制 → 决策逻辑 → 动态流程展开;行为链统一写作:证据 → 内部决策 → 助手行为。图中的 A/U 波形是辅助示意。
L0 外部模块系统
Section titled “L0 外部模块系统”生成链路为:用户音频 → ASR → LLM → TTS → 播放。与它并行的双工控制器包括 pVAD、话轮结束(EoT)检测器和对话管理器,观察音频活动、话轮结束与转写、播放状态,再发出等待、说话、打断或重新处理等显式控制。
观察 → 决策 → 执行:观察用户活动、话轮结束和播放状态;决定等待、回复还是打断;作用到 TTS 和播放,例如保持输出、开始说话、停止播放或重新处理。图中灰色虚线表示观察,棕色箭头表示执行。
| 动态 | 证据 | 控制决定 | 助手行为 |
|---|---|---|---|
| 话轮转换 | 用户说话 | 检测到话轮结束 | 助手开始说话 |
| 重叠的话轮转换 | 播放期间出现新语音 | 判断为打断 | 停止或重新处理 |
| 不转移话轮 | 背景声音或附和 | 没有发生话轮转移 | 保持或沉默 |
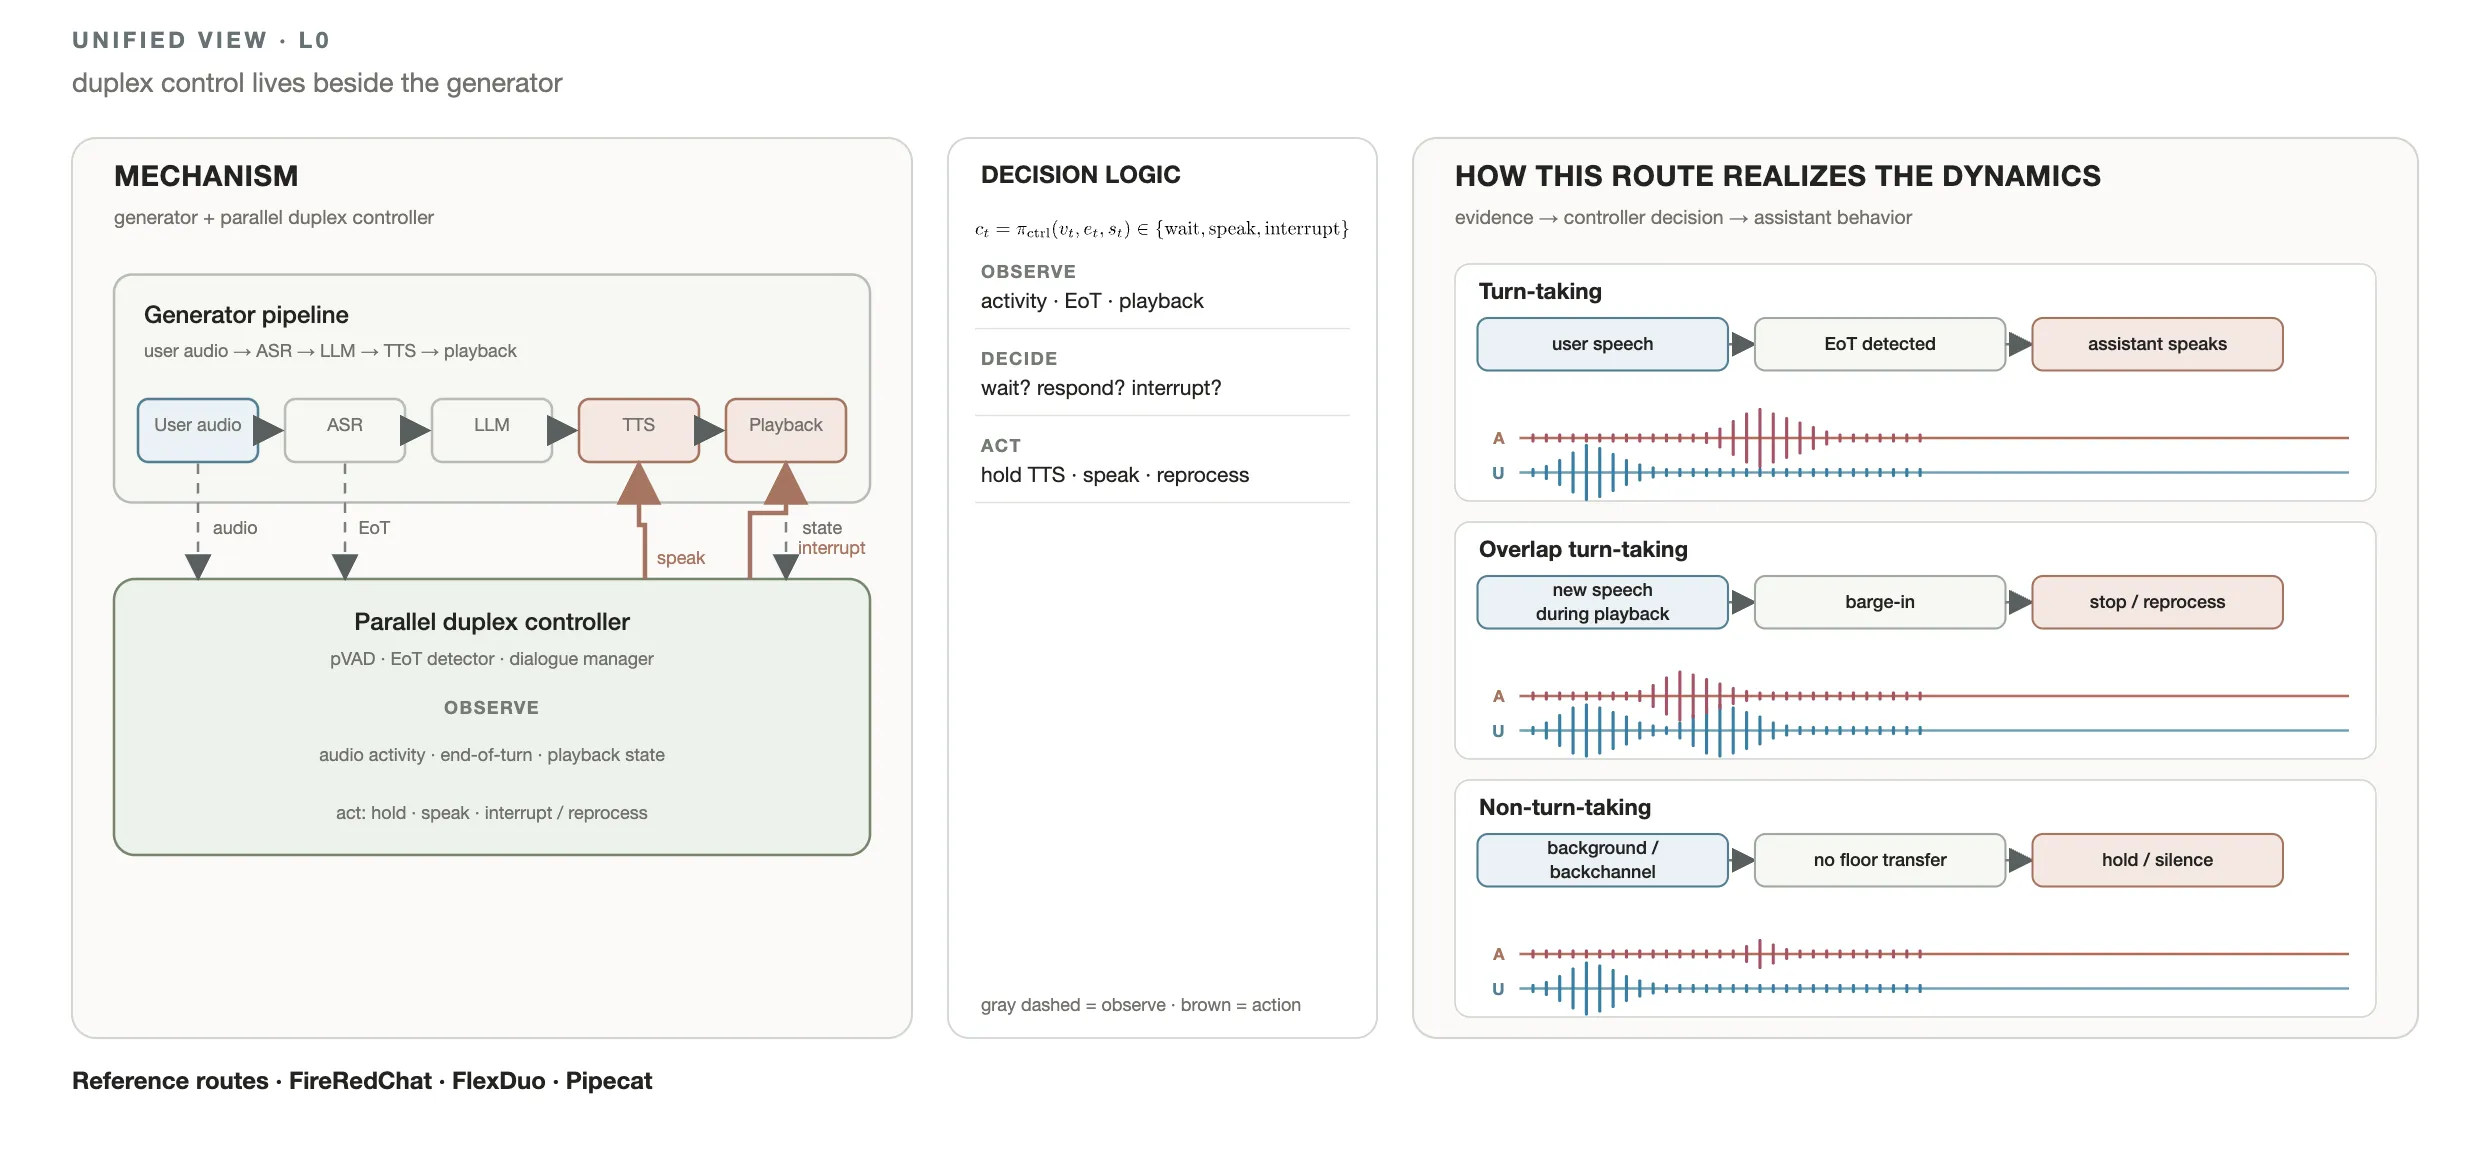
示例路线:FireRedChat、FlexDuo、Pipecat。论文来源:FireRedChat A Pluggable Full-Duplex Voice Interaction System。
L1 隐藏状态桥接
Section titled “L1 隐藏状态桥接”用户音频经过 Encoder + LLM 更新共享的隐藏状态 h_t。语音生成分支和双工预测器都读取 h_t,因此 h_t 是两类决策共享的控制边界。新的音频先改变模型状态,再影响接下来的动作。
观察 → 决策 → 执行:观察更新后的 h_t;预测回应、等待、停止等状态;语音生成分支根据状态继续、停止或重定向。
| 动态 | 证据 | 状态或预测 | 助手行为 |
|---|---|---|---|
| 话轮转换 | 新音频更新 h_t | 预测器选择回应 | 生成回答 |
| 重叠的话轮转换 | 生成过程中用户开始说话 | h_t 影响停止或倾听的决策 | 停止或重定向生成分支 |
| 不转移话轮 | 音频更新 h_t | 没有发生话轮转移 | 保持或继续 |
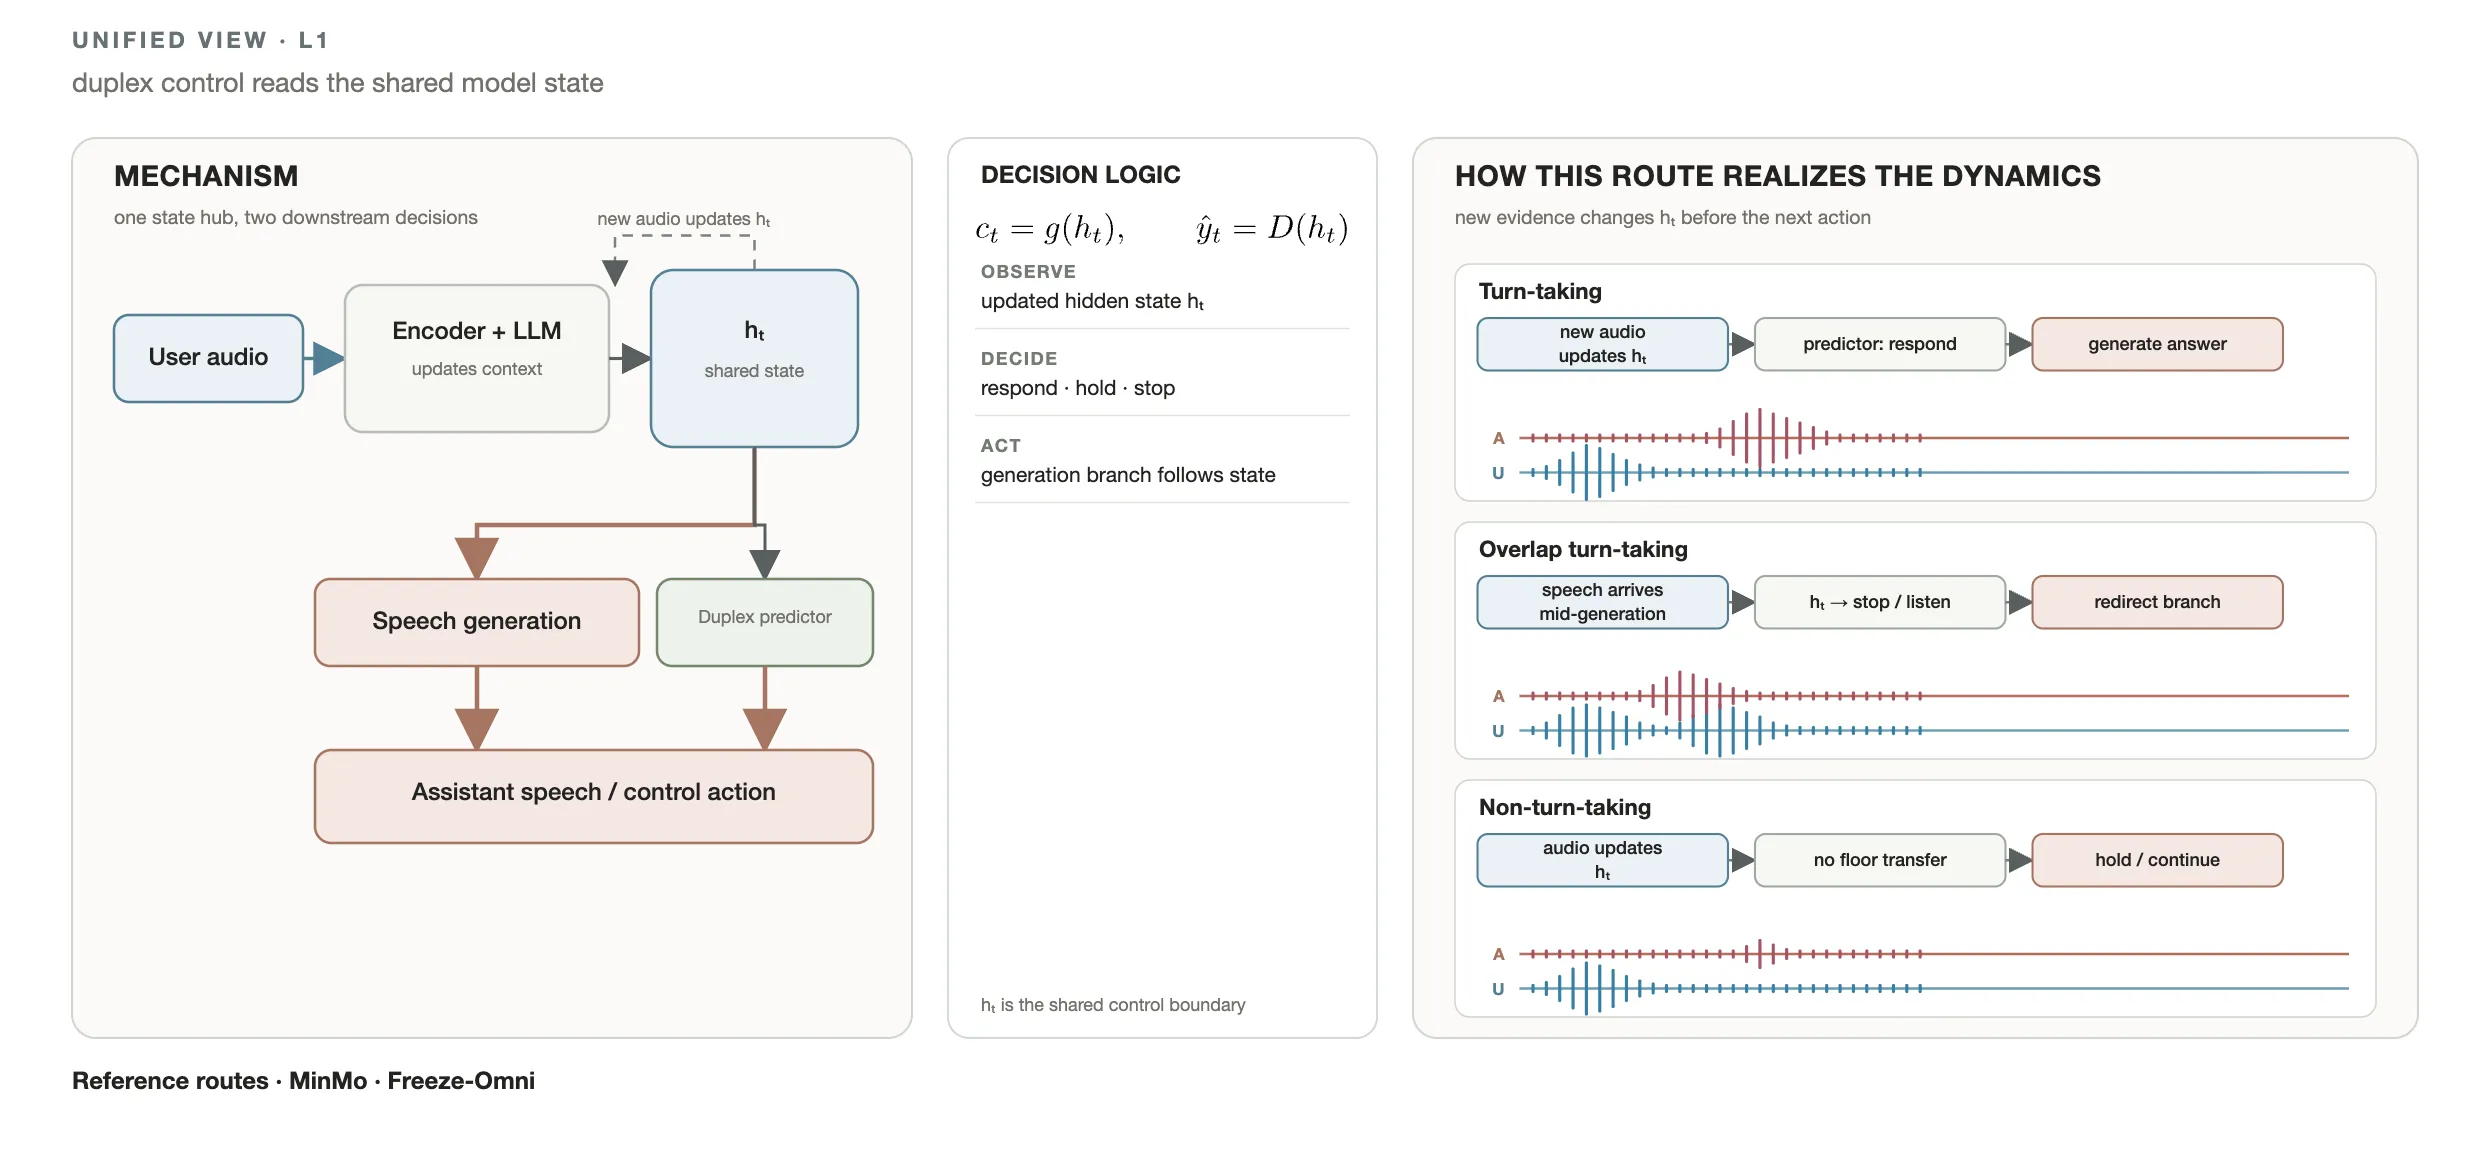
示例路线:MinMo A Multimodal Large Language Model for Seamless Voice Interaction、Freeze-Omni A Smart and Low Latency Speech-to-speech Dialogue Model。
L2 token 级建模
Section titled “L2 token 级建模”新的用户 token 或块进入持续的因果上下文 z_≤t,改变下一个输出 o_t+1。交互决定由生成序列承载:下一个 token 或块的语义可以是语音、沉默、控制信号或简短的附和。
序列调度决定新证据从哪里进入上下文:
-
并行通道,例如 Moshi。
-
展平的单一序列,例如 OmniFlatten。
-
同步的块,例如 SyncLLM、LSLM。
观察 → 决策 → 执行:观察持续上下文及新的用户证据;通过下一个 token 或块的语义形成决策;生成语音、沉默或附和。
| 动态 | 证据 | 下一输出的语义 | 助手行为 |
|---|---|---|---|
| 话轮转换 | 用户 token 进入上下文 | 对方让出 → 开口 | 开始回应 |
| 重叠的话轮转换 | 用户与模型的 token 共存 | 打断或切换 | 改变当前生成走向 |
| 不转移话轮 | 背景声或附和的 token | 沉默或简短附和 | 保持当前交互或给出简短附和 |
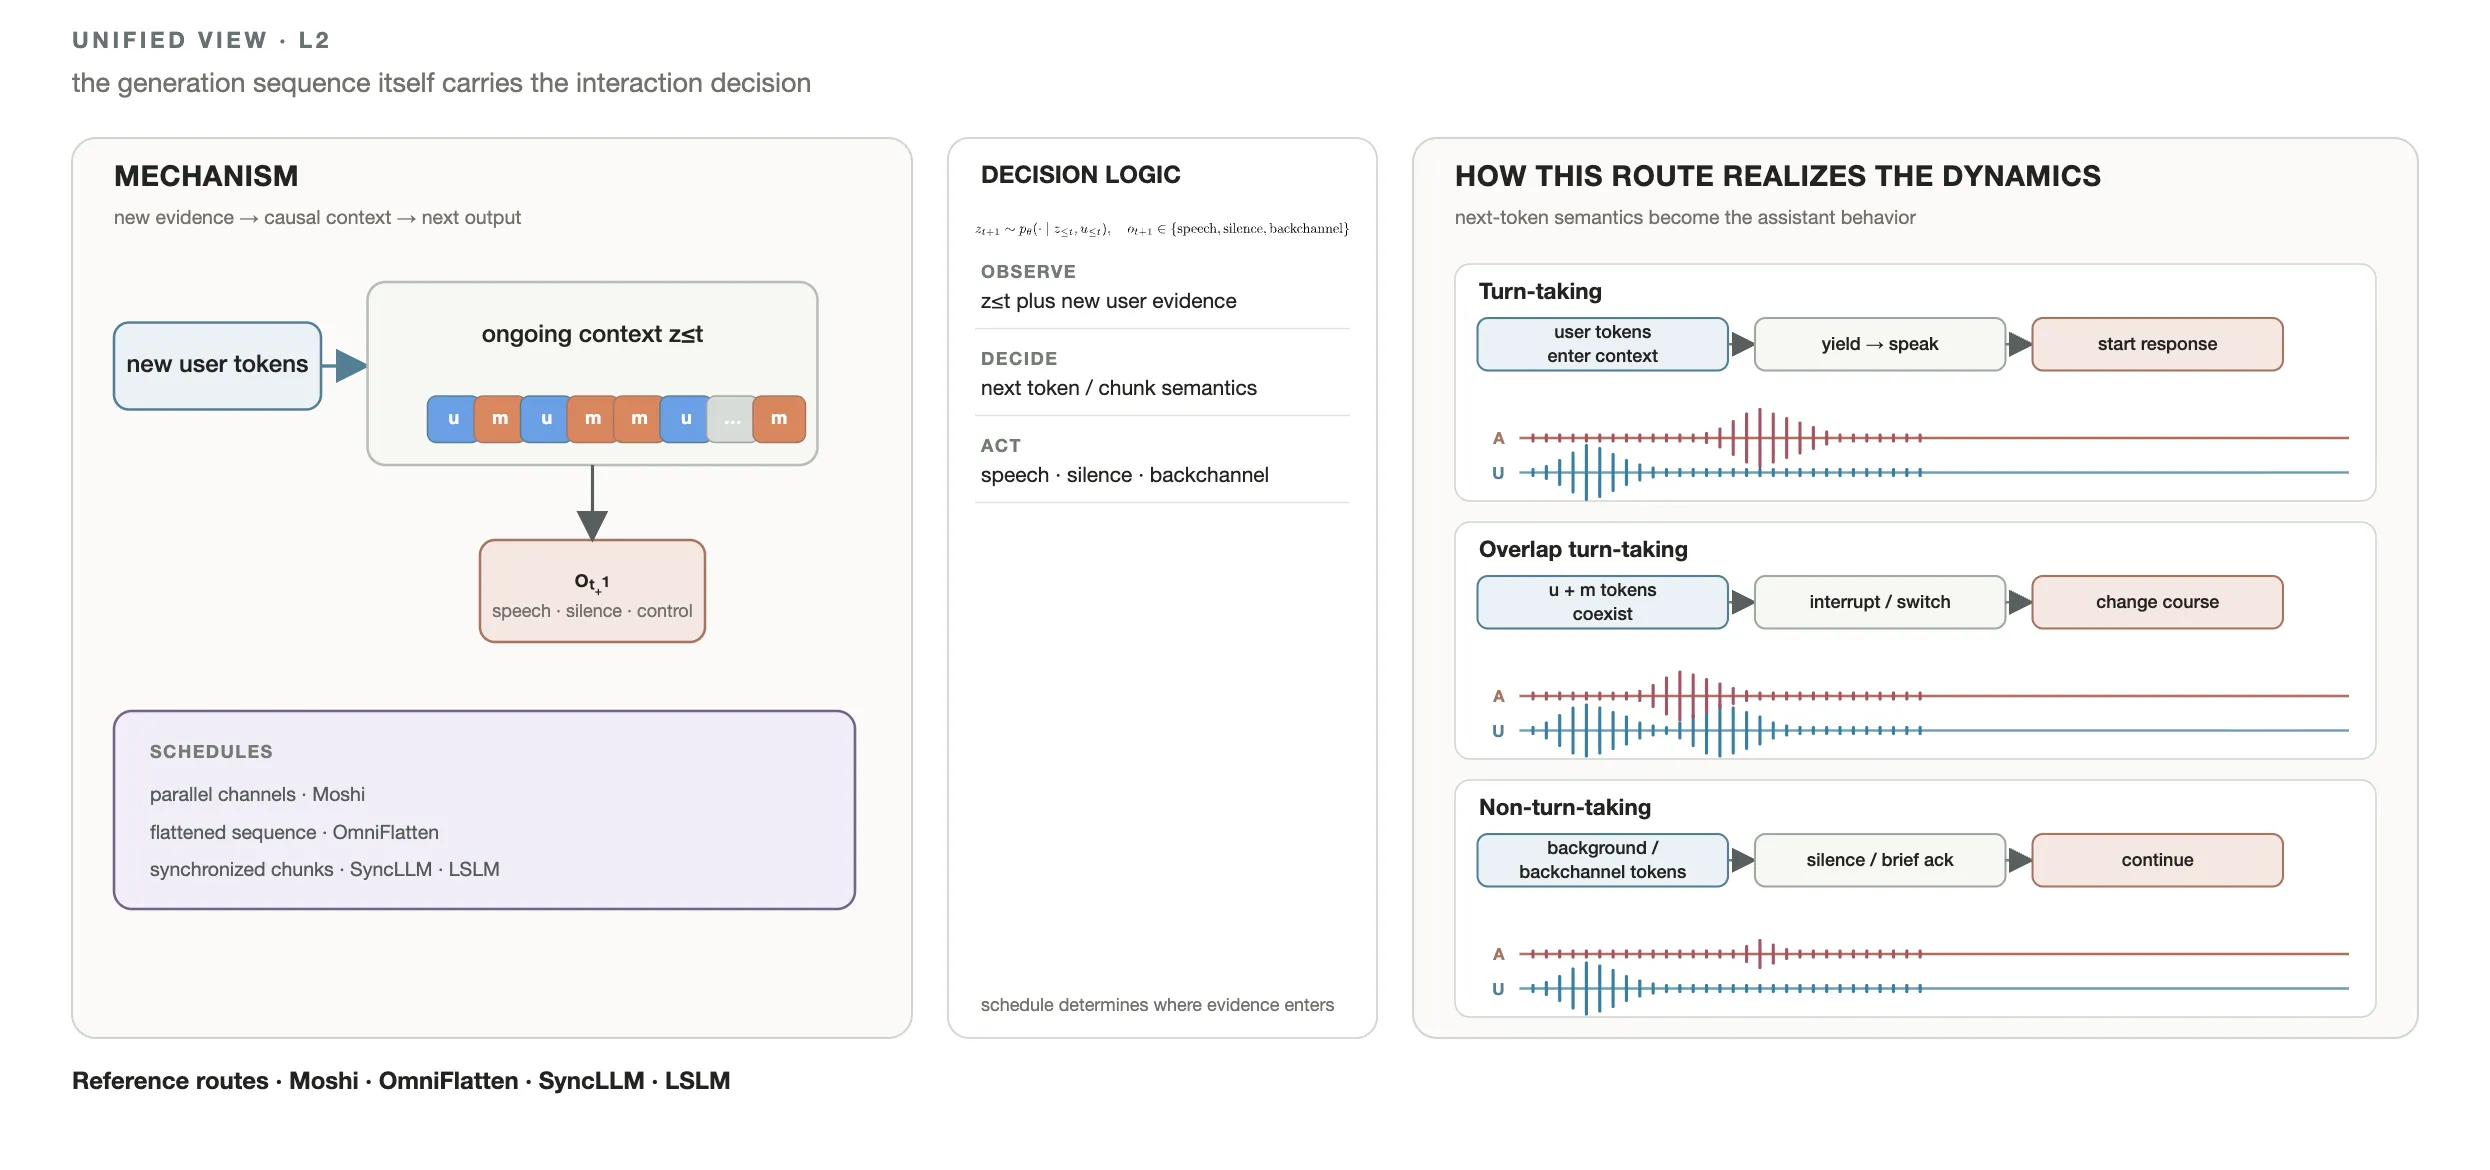
示例路线:Moshi、OmniFlatten、SyncLLM、LSLM。
分层与对话动态的总体参考:A Survey of Full-Duplex Spoken Dialogue Systems Architectural Hierarchy Interaction Ontology and Decision State Machine。
8 研究版图和后续问题
Section titled “8 研究版图和后续问题”| 研究层级 | 关注内容 | 本页覆盖情况 |
|---|---|---|
| 应用层 | 交互模型的应用版图 | 属于完整研究版图,本页未展开 |
| 评测层 | 客观评测;主观评测 | 待补充 |
| 交互层 | 对话动态;交际能力 | 已展开 |
| 模型层 | 建模交互;建模音频序列 | 已展开 |
| 数据与训练层 | 数据构造;训练策略 | 待补充 |
本页主线覆盖交互层和模型层。接下来需要补充评测,以及数据与训练:如何评价自然交互、如何构造相应数据,以及采用什么训练策略。
9 参考资料
Section titled “9 参考资料”各模型的官方资料与论文已在相应章节和表格中给出链接。